Разбираемся с прямым и обратным порядком байтов
Наиболее важная концепция заключается в понимании разницы между числами и данными, которые эти числа представляют. Число — это абстрактное понятия, как исчислитель чего-то. У Вас есть десять пальцев. Понятие “десять” не меняется, в зависимости от использованного представления: десять, 10, diez (испанский), ju (японский), 1010 (бинарное представление), Х (римские числа)… Все эти представления указывают на понятие “десяти”.
Сравним это с данными. Данные — это физическое понятие, просто последовательность битов и байтов, хранящихся на компьютере. Данные не имеют неотъемлемого значения и должны быть интерпретированы тем, кто их считывает.
Данные — это как человеческое письмо, просто набор отметок на бумаге. Этим отметкам не присуще какое-либо значение. Если мы видим линию и круг (например, |O), то можно интерпретировать это как “десять”. Но это лишь предположение, что считанные символы представляют число. Это могут быть буквы “IO” — название спутника Юпитера. Или, возможно, имя греческой богини. Или аббревиатура для ввода/вывода. Или чьи-то инициалы. Или число 2 в бинарном представлении (“10”). Этот список предположений можно продолжить. Дело в том, что один фрагмент данных (|O) может быть интерпретировано по разному, и смысл остается не ясен, пока кто-то не уточнит намерения автора.
Компьютеры сталкиваются с такой же проблемой. Они хранят данные, а не абстрактные понятия, используя при этом 1 и 0. Позднее они считывают эти 1 и 0 и пытаются воссоздать абстрактные понятия из набора данных. В зависимости от сделанных допущений, эти 1 и 0 могут иметь абсолютно разное значение.
Почему так происходит? Ну, вообще-то нет такого правила, что компьютеры должны использовать один и тот же язык, так же, как нет такого правила и для людей. Каждый компьютер одного типа имеет внутреннюю совместимость (он может считывать свои собственные данные), но нет никакой гарантии, как именно интерпретирует эти данные компьютер другого типа.
- Данные (биты и байты или отметки на бумаге) сами по себе не имеют смысла. Они должны быть интерпретированы в какое-то абстрактное понятие, например, число.
- Как и люди, компьютеры имеют различные способы хранения одного и того же абстрактного понятия (например, мы можем различными способами сказать “10”).
Храним числа как данные
- Бит имеет два состояния (включен или выключен, 1 или 0).
- Байт — это последовательность из 8 бит. Крайний левый бит в байте является старшим. То есть двоичная последовательность 00001001 является десятичным числом девять. 00001001 = (2^3 + 2^0 = 8 + 1 = 9).
- Биты нумеруются справа налево. Бит 0 является крайним правым и он наименьший. Бит 7 является крайним левым и он наибольший.
Так в чем же проблема — компьютеры отлично ладят с одиночными байтами, правда? Ну, все превосходно для однобайтных данных, таких как ASCII-символы. Однако, много данных используют для хранения несколько байтов, например, целые числа или числа с плавающей точкой. И нет никакого соглашения о том, в каком порядке должны хранится эти последовательности.
Пример с байтом
Рассмотрим последовательность из 4 байт. Назовем их W X Y и Z. Я избегаю наименований A B C D, потому что это шестнадцатеричные числа, что может немного запутывать. Итак, каждый байт имеет значение и состоит из 8 бит.
Имя байта W X Y Z Позиция 0 1 2 3 Значение (hex) 0x12 0x34 0x56 0x78 Например, W — это один байт со значением 0х12 в шестнадцатеричном виде или 00010010 в бинарном. Если W будет интерпретироваться как число, то это будет “18” в десятеричной системе (между прочим, ничто не указывает на то, что мы должны интерпретировать этот байт как число — это может быть ASCII-символ или что-то совсем иное). Вы все еще со мной? Мы имеем 4 байта, W X Y и Z, каждый с различным значением.
Понимаем указатели
Указатели являются ключевой частью программирования, особенно в языке С. Указатель представляет собой число, являющееся адресом в памяти. И это зависит только от нас (программистов), как интерпретировать данные по этому адресу.
В языке С, когда вы кастите (приводите) указатель к конкретному типу (такому как char * или int *), это говорит компьютеру, как именно интерпретировать данные по этому адресу. Например, давайте объявим:
void *p = 0; // p указатель на неизвестный тип данных // p нулевой указатель - не разыменовывать char *c; // c указатель на один байт Обратите внимание, что мы не можем получить из р данные, потому что мы не знаем их тип. р может указывать на цифру, букву, начало строки, Ваш гороскоп или изображение — мы просто не знаем, сколько байт нам нужно считать и как их интерпретировать.
Теперь предположим, что мы напишем:
c = (char *)p; Этот оператор говорит компьютеру, что р указывает на то же место, и данные по этому адресу нужно интерпретировать как один символ (1 байт). В этом случае, с будет указывать на память по адресу 0, или на байт W. Если мы выведем с, то получим значение, хранящееся в W, которое равно шестнадцатеричному 0x12 (помните, что W — это полный байт). Этот пример не зависит от типа компьютера — опять же, все компьютеры одинаково хорошо понимают, что же такое один байт (в прошлом это было не всегда так).
Этот пример полезен, он одинаково работает на все компьютерах — если у нас есть указатель на байт (char *, один байт), мы можем проходить по памяти, считывая по одному байту за раз. Мы можем обратиться к любому месту в памяти, и порядок хранения байт не будет иметь никакого значения — любой компьютер вернет нам одинаковую информацию.
Так в чем же проблема?
Проблемы начинаются, когда компьютер пытается считать несколько байт. Многие типы данных состоят больше чем из одного байта, например, длинные целые (long integers) или числа с плавающей точкой. Байт имеет только 256 значений и может хранить числа от 0 до 255.
- Машины с порядком хранения от старшего к младшему (прямой порядок) хранят старший байт первым. Если посмотреть на набор байтов, то первый байт (младший адрес) считается старшим.
- Машины с порядком хранения от младшего к старшему (обратный порядок) хранят младший байт первым. Если посмотреть на набор байт, то первый байт будет наименьшим.
Повторюсь, порядок следования байтов не имеет значения пока Вы работаете с одним байтом. Если у Вас есть один байт, то это просто данные, которые Вы считываете и есть только один вариант их интерпретации (опять таки, потому что между компьютерами согласовано понятие одного байта).
Теперь предположим, что у нас есть 4 байта (WXYZ), которые хранятся одинаково на машинах с обоими типами порядка записи байтов. То есть, ячейка памяти 0 соответствует W, ячейка 1 соответствует X и т. д.
Мы можем создать такое соглашение, помня, что понятие “байт” является машинно-независимым. Мы можем обойти память по одному байту за раз и установить необходимые значения. Это будет работать на любой машине.
c = 0; // указывает на позицию 0 (не будет работать на реальной машине!) *c = 0x12; // устанавливаем значение W c = 1; // указывает на позицию 1 *c = 0x34; // устанавливаем значение X . // то же повторяем для Y и Z Такой код будет работать на любой машине и успешно установит значение байт W, X, Y и Z расположенных на соответствующих позициях 0, 1, 2 и 3.
Интерпретация данных
Теперь давайте рассмотрим пример с многобайтными данными (наконец-то!). Короткая сводка: “short int” это 2-х байтовое число (16 бит), которое может иметь значение от 0 до 65535 (если оно беззнаковое). Давайте используем его в примере.
short *s; // указатель на short int (2 байта) s = 0; // указатель на позицию 0; *s это значение - Машина с прямым порядком хранения: Я думаю, short int состоит из двух байт, а значит я считаю их. Позиция s это адрес 0 (W или 0х12), а позиция s + 1 это адрес 1 (X или 0х34). Поскольку первый байт является старшим, то число должно быть следующим 256 * байт 0 + байт 1 или 256 * W + X, или же 0х1234. Я умножаю первый байт на 256 (2^8) потому что его нужно сдвинуть на 8 бит.
- Машина с обратным порядком хранения: Я не знаю что курит мистер “От старшего к младшему”. Я соглашусь, что short int состоит из 2 байт и я считаю их точно также: позиция s со значение 0х12 и позиция s + 1 со значением 0х34. Но в моем мире первым является младший байт! И число должно быть байт 0 + 256 * байт 1 или 256 * X + W, или 0х3412.
Теперь Вы видите проблему? Машина с порядком хранения от старшего к младшему считает, что s = 0x1234, в то время как машина с порядком хранения от младшего к старшему думает, что s = 0x3412. Абсолютно одинаковые данные дают в результате два совершенно разных числа.
И еще один пример
Давайте для “веселья” рассмотрим еще один пример с 4 байтовым целым:
int *i; // указатель на int (4 байты 32-битовой машине) i = 0; // указывает на позицию 0, а *i значение по этому адресу - Машина с прямым порядком хранения: тип int состоит из 4 байт и первый байт является старшим. Считываю 4 байта (WXYZ) из которых старший W. Полученное число: 0х12345678.
- Машина с обратным порядком хранения: несомненно, int состоит из 4 байт, но старшим является последний. Так же считываю 4 байта (WXYZ), но W будет расположен в конце — так как он является младшим. Полученное число: 0х78563412.
Проблема NUXI
Проблему с порядком байт иногда называют проблемой NUXI: слово UNIX, сохраненное на машинах с порядком хранения от старшего к младшему, будет отображаться как NUXI на машинах с порядком от младшего к старшему.
Допустим, что мы собираемся сохранить 4 байта (U, N, I, и X), как два short int: UN и IX. Каждая буква занимает целый байт, как в случае с WXYZ. Для сохранения двух значений типа short int напишем следующий код:
short *s; // указатель для установки значения переменной типа short s = 0; // указатель на позицию 0 *s = UN; // устанавливаем первое значение: U * 256 + N (вымышленный код) s = 2; // указатель на следующую позицию *s = IX; // устанавливаем второе значение: I * 256 + X Этот код не является специфичным для какой-то машины. Если мы сохраним значение “UN” на любой машине и считаем его обратно, то обратно получим тоже “UN”. Вопрос порядка следования байт не будет нас волновать, если мы сохраняем значение на одной машине, то должны получить это же значение при считывании.
Однако, если пройтись по памяти по одному байту за раз (используя трюк с char *), то порядок байт может различаться. На машине с прямым порядком хранения мы увидим:
Byte: U N I X Location: 0 1 2 3 Что имеет смысл. “U” является старшим байтом в “UN” и соответственно хранится первым. Такая же ситуация для “IX”, где “I” — это старший байт и хранится он первым.
На машине с обратным порядком хранения мы скорее всего увидим:
Byte: N U X I Location: 0 1 2 3 Но и это тоже имеет смысл. “N” является младшим байтом в “UN” и значит хранится он первым. Опять же, хотя байты хранятся в “обратном порядке” в памяти, машины с порядком хранения от младшего к старшему знают что это обратный порядок байт, и интерпретирует их правильно при чтении. Также, обратите внимание, что мы можем определять шестнадцатеричные числа, такие как 0x1234, на любой машине. Машина с обратным порядком хранения байтов знает, что Вы имеете в виду, когда пишите 0x1234 и не заставит Вас менять значения местами (когда шестнадцатеричное число отправляется на запись, машина понимает что к чему и меняет байты в памяти местами, скрывая это от глаз. Вот такой трюк.).
Рассмотренный нами сценарий называется проблемой “NUXI”, потому что последовательность “UNIX” интерпретируется как “NUXI” на машинах с различным порядком хранения байтов. Опять же, эта проблема возникает только при обмене данными — каждая машина имеет внутреннюю совместимость.
Обмен данными между машинами с различным порядком хранения байтов
Сейчас компьютеры соединены — прошли те времена, когда машинам приходилось беспокоиться только о чтении своих собственных данных. Машинам с различным порядком хранения байтов нужно как-то обмениваться данными и понимать друг друга. Как же они это делают?
Решение 1: Использовать общий формат
Самый простой подход состоит в согласовании с общим форматом для передачи данных по сети. Стандартным сетевым является порядок от старшего к младшему, но некоторые люди могут расстроиться, что не победил порядок от младшего к старшему, поэтому просто назовем его “сетевой порядок”.
Для конвертирования данных в соответствии с сетевым порядком хранения байтов, машины вызывают функцию hton() (host-to-network). На машинах с прямым порядком хранения эта функция не делает ничего, но мы не будем говорить здесь об этом (это может разозлить машины с обратным порядком хранения 🙂 ).
Но важно использовать функцию hton() перед отсылкой данных даже если Вы работаете на машине с порядком хранения от старшего к младшему. Ваша программа может стать весьма популярной и будет скомпилирована на различных машинах, а Вы ведь стремитесь к переносимости своего кода (разве не так?).
Точно также существует функция ntoh() (network-to-host), которая используется для чтения данных из сети. Вы должны использовать ее, чтобы быть уверенными, что правильно интерпретируете сетевые данные в формат хоста. Вы должны знать тип данных, которые принимаете, чтобы расшифровать их правильно. Функции преобразования имеют следующий вид:
htons() - "Host to Network Short" htonl() - "Host to Network Long" ntohs() - "Network to Host Short" ntohl() - "Network to Host Long" Помните, что один байт — это один байт и порядок не имеет значения.
Эти функции имеют критическое значение при выполнении низкоуровневых сетевых операций, таких как проверка контрольной суммы IP-пакетов. Если Вы не понимаете сути проблемы с порядком хранения байтов, то Ваша жизнь будет наполнена болью — поверьте мне на слово. Используйте функции преобразования и знайте, зачем они нужны.
Решение 2: Использования маркера последовательности байтов (Byte Order Mark — BOM)
Этот подход подразумевает использование некого магического числа, например 0xFEFF, перед каждым куском данных. Если Вы считали магическое число и его значение 0xFEFF, значит данные в том же формате, что и у Вашей машины и все хорошо. Если Вы считали магическое число и его значение 0xFFFE, это значит, что данные были записаны в формате, отличающемся от формата вашей машины и Вы должны будете преобразовать их.
Нужно отметить несколько пунктов. Во-первых, число не совсем магическое, как известно программисты часто используют этот термин для описания произвольно выбранных чисел (BOM может быть любой последовательностью различных байтов). Такая пометка называется маркером последовательности байтов потому что показывает в каком порядке данные были сохранены.
Во-вторых, BOM добавляет накладные расходы для всех передаваемых данных. Даже в случае передачи 2 байт информации Вы должны добавлять к ним 2 байта маркера BOM. Пугающе, не так ли?
Unicode использует BOM, когда сохраняет многобайтные данные (некоторые кодировки Unicode могут иметь по 2, 3 и даже 4 байта на символ). XML позволяет избежать этой путаницы, сохраняя данные сразу в UTF-8 по умолчанию, который сохраняет информацию Unicode по одному байту за раз. Почему это так круто?
Повторяю в 56-й раз — потому что проблема порядка хранения не имеет значения для единичных байт.
Опять же, в случае использования BOM может возникнуть другие проблемы. Что, если Вы забудете добавить BOM? Будете предполагать, что данные были отправлены в том же формате, что и Ваши? Прочитаете данные и, увидев что они “перевернуты” (что бы это не значило), попытаетесь преобразовать их? Что, если правильные данные случайно будут содержать неправильный BOM? Эти ситуации не очень приятные.
Почему вообще существует эта проблема? Нельзя ли просто договориться?
Ох, какой же это философский вопрос. Каждый порядок хранения байтов имеет свои преимущества. Машины с порядком следования от младшего к старшему позволяют читать младший байт первым, не считывая при этом остальные. Таким образом можно легко проверить является число нечетным или четным (последний бит 0), что очень здорово, если Вам необходима такая проверка. Машины с порядком от старшего к младшему хранят данные в памяти в привычном для человека виде (слева направо), что упрощает низкоуровневую отладку.
Так почему же все просто не договорятся об использовании одной из систем? Почему одни компьютеры пытаются быть отличными от других? Позвольте мне ответить вопросом на вопрос: почему не все люди говорят на одном языке? Почему в некоторых языках письменность слева направо, а у других справа налево?
Иногда системы развиваются независимо, а в последствии нуждаются во взаимодействии.
Эпилог: Мысли на прощание
Вопросы с порядком хранения байтов являются примером общей проблемы кодирования — данные должны представлять собой абстрактные понятия, и позднее это понятие должно быть создано из данных. Эта тема заслуживает отдельной статьи (или серии статей), но Вы должны иметь лучшее понимание проблемы, связанной с порядком хранения байтов.
Байты и биты: что нужно знать об их порядке

В программировании и информатике все данные сохраняются в определенных единицах. Они будут обрабатываться операционной системой особым образом. Зная об измерении данных, а также о так называемом «порядке байт», разработчик сможет оптимизировать функционирование программного продукта.
Далее предстоит разобраться с тем, как обрабатывается информация. Необходимо выяснить возможные варианты и их особенности. Предложенная статья ориентирована на широкую публику. Представленные сведения будут одинаково полезны как программистам, так и системным администраторам. Они также могут показаться интересными «рядовым» пользователям ПК.
Единицы измерения
В компьютерах вся информация измеряется определенным образом. Исторически сложилось так, что минимальной единицей количества данных является бит. Этот термин произошел от английского сокращения bit или binary digit. Дословно соответствующее слово переводится как «двоичная цифра».
Бит – количество информации, которого достаточно для установки различий между двумя явлениями с одинаковой долей вероятности. Им можно интерпретировать одно из двух понятия:
- 0 – верно, включено, да;
- 1 – неверно, отключено, нет.
Бит – наименьшая единицы счисления данных. Чаще разработчики пользуются более «крупными» мерами. А именно – байтами. Один байт включает в себя 8 бит.

Выше можно увидеть таблицу, которая поможет понять, как переводить более крупные единицы измерения имеющиеся информационные единицы.
Об истоках появления байтового порядка
Порядок байтов (или «endian») – важный элемент, оказывающий влияние на работу IT-инженеров и программного обеспечения. Соответствующий компонент не является отдельным термином. Изучая порядок байтов, необходимо обратить внимание на такие определения как «прямой порядок» (big-endian) и «обратный порядок» (little-endian).
Подобные понятия были взяты из книги «Путешествия Гулливера». В ней начинается гражданская война между теми, кто предпочитает разбивать вареные яйца на большом конце (big endians), а также теми, кто предпочитает делать это на маленьком конце (little endians).
В 1980 году некий Денни Коэн, специалист по компьютерам из Израиля, написал статью, в которой он раскрыл вопрос относительно правильного порядка байтов в сообщениях. В своем творении автор связал тематику с «войной», описанной в «Гулливере».
Для описания дискуссий о байтовом порядке (endianness) использовались термины «big endian» и «little endian».
Определение
Современная вычислительная техника и цифровые системы связи представляют чаще всего информацию в виде последовательности. Она формируется из байтов. Если число не может быть реализовано в качестве одного байта, имеет смысл, в каком порядке они записываются на устройстве, а затем передаются по линиям связи. Данный момент сказывается на скорости и качестве обработки материалов.
Обычно выбор порядка записи байтов является произвольным. Он определяется исключительно действующими соглашениями. Порядок байтов – это последовательность, в которой информация будет сохраняться и размещаться в памяти задействованного оборудования.
Актуальность и важность
Сатирическая трактовка в сравнении с произведением «Путешествия Гулливера» big endians (прямой порядок, от старшего к младшему) против little endians (обратного порядка, от младшего к старшему), рассматриваемый вопрос имеет важность для работы с информацией и документами.
Здесь рекомендуется запомнить следующие значимые аспекты:
- Блок цифровой информации представляет собой последовательность из нулей и единиц.
- Соответствующие единицы и нули начинаются с наименьшего значащего бита (least significant bit, LSb). Заканчиваются они на наибольшем значащем бите (most significant bit, MSb).
- 32-разрядный процессор передает 32 бита информации в 32 блока памяти. 64-разрядный – в 64 соответственно.
Чтобы лучше понять, в чем заключается смысл порядка байтов, рекомендуется изучить простейший пример. В нем дан 32-разрядный процессор. Он будет передавать информацию в 32 информационных блока памяти. Им совместно назначается тот или иной адрес. Пример – 0x01. Шина данных в системе создана так, что смешивать LSb и MSb нельзя. Все операции устройства будут использовать 32-битные данные, даже если соответствующие числа могут быть с легкостью реализованы в 16 или 8 битами.
Каждый раз, когда процессор должен получить доступ к сохраненной информации, он просто считает 32 бита из адреса памяти 0x01. Соответствующая концепция является надежной. В порядке байтов нет необходимости.
Рассматриваемый процесс был основан на работе битов. «Байт» не упоминалось. Процессы базируются на 32-битных данных. Делить их на байты не требуется. Реальные цифровые системы, работающие с 32-битными и 64-битными материалами, обычно используют 8-битный сегмент данных. Он известен в информационных технологиях как «байт».
Как на устройстве распределяются байты памяти
Удобное средство демонстрации порядка байтов в действии – это процесс хранения цифровой информации. Пример – используется 8-разрядный микроконтроллер. Все аппаратное обеспечение на устройстве, включая ячейки памяти, предназначаются для работы с 8-битными данными. Адрес 0x00 может включать в себя всего один байт, адрес 0x01 – тоже один и так далее.

Схема, представленная выше, демонстрирует 11 байтов памяти. Каждая из них хранит всего по 8 бит информации.
Для программирования микроконтроллера, пользуясь компилятором C, порядок байтов будет иметь особую роль. Компилятор должен определить 32-разрядные переменные и хранить их в смежных ячейках памяти. В самом младшем адресе памяти должен хранить наибольший значащий байт (MSB) или наименьший значащий байт (LSB).
Это приводит к тому, что системы могут работать по двум принципам:
- соблюдая порядок имеющихся байтов big endian – распределение байтов от старшего к младшему;
- по принципу little endian – от младшего к старшему.
Какой именно вариант правильно использовать, ответить проблематично. Связано это с тем, что любая договоренность может быть одинаково эффективной. Решения между прямым и обратным порядком байтов может базироваться на различных факторах. Пример – на поддержке совместимости с предыдущими версиями процессора.
Кроме прямого и обратного порядка распределения информации есть еще «гибридный» подход. Он не так распространен, но встречается на практике в современных технологиях.
Обратный порядок
Обратный порядок информационных байтов – это принцип «от младшего к старшему». Он называется little endian. Это порядок, обратный «привычному» порядку записи чисел арабскими цифрами. Пример – число 123 было бы записано как 321. Принцип распределения и записи информации здесь будет производиться по правилу «справа–налево».
Обратный порядок информационных байтов является стандартом компьютеров с процессорами архитектуры x86 (Intel и других). Из-за этой особенности концепция иногда называется «интеловским порядком). Современные процессоры x86 дают возможность работать с операндами, рассчитанными на bites:
Соответствующий порядок удобен тем, что при увеличении размера (количества байтов) операнда, значение первого байта остается неизменным.
Кроме архитектуры x86 от Intel соответствующий принцип распределения информации активно используется в VAX-архитектурах (VAX byte order), а также в DEC Alpha и многих других.

Принцип обратного порядка байтов (little endian) применяется в PCI, USB, таблице разделов GUID. Он является рекомендованным принципом FidoNet. Данное соглашение поддерживает меньше кроссплатформенных протоколов и форматов данных, чем прямой порядок байт.
Прямой порядок
Следующий вариант распределения информации в битовых системах – «напрямую». Он называется прямым порядком байтов, big Indian. Он называется «от старшего к младшему». Является классической формой записи. Порядок следования – «слева–направо». Пример – число «сто двадцать пять» будет записано как 125. В этом же ключе необходимо осуществлять запись битов (байтов) в технической и учебной литературе, если иные особенности операций не указаны.
Принцип записи «всегда вперед» или «от большего к меньшему» – стандарт, который используется в Сети. Он иногда называется «network byte order». Встречается в:
- протоколах TCP/IP;
- заголовках пакетов данных;
- в большинстве протоколов более высокого уровня, которые необходимо использовать поверх TCP/IP.
Такая последовательность байтов в основном задействована в процессорах IBM 360/370/390, SPARC, Motorola 68000. Из-за соответствующей особенности есть второй способ обозначения соглашения – «Motorola byte order).
Правильный принцип использования порядка распределения байтов big endian – сравнение строк (пример – с целыми числами и целочисленными полями-частями большей разрядности, каждое из которых поддерживает сразу несколько символов.
Данное соглашение используется в различных файловых форматах. Примеры – JPEG, FLV, PNG.
Переключаемый
Какой порядок байт в Intel, понятно. Обе рассмотренные концепции примерно равны между собой. Поэтому иногда бывает трудно указать, какой стандарт правильный для поставленной в разработке задачи.
Некоторые процессоры могут функционировать сразу по обеим концепциям. Сюда относят:
- ARM;
- PowerPC;
- DEC Alpha;
- IA-64;
- PA-RISC;
- MIPS.
Последовательность байтов будет выбираться программно во время установки операционной системы. Иногда он настраивается за счет перемычек на материнских платах. Иногда данную концепцию называют big-endian.
Смешанный
Следующий вариант – гибридный или смешанный порядок байтов. Называется middle endian. Он используется при работе с числами, длина которых больше машинного слова. Число будет представлено некоторой последовательностью машинных слов. Они записываются в формате, естественном для выбранной архитектуры. Сами машинные слова следуют в обратном порядке.
Смешанный порядок байтов встречается в процессорах VAX и ARM. В основном концепция задействована при работе с длинными вещественными числами.
Пример
Чтобы лучше понять рассматриваемые процессы, рекомендуется обратить внимание на наглядный пример:

Здесь описано размещение 4-байтового числа в памяти устройства, доступ к которому поддерживается побайтно и по 32-разрядному слову. Все числа представлены в 16-ричной системе счисления.
Хотите освоить современную IT-специальность? Огромный выбор курсов по востребованным IT-направлениям есть в Otus !
Сокеты Windows. Порядок байтов
В этой статье и двух дополнительных статьях объясняется несколько проблем программирования сокетов Windows. В этой статье рассматриваются упорядочение байтов. Другие проблемы рассматриваются в статьях: сокеты Windows: блокировка и сокеты Windows: преобразование строк.
Если вы используете или извлекаете из класса CAsyncSocket, вам потребуется самостоятельно управлять этими проблемами. При использовании или производных от класса CSocket MFC управляет ими.
Порядок байтов
Разные архитектуры компьютеров иногда хранят данные с помощью разных заказов байтов. Например, компьютеры на основе Intel хранят данные в обратном порядке компьютеров Macintosh (Motorola). Порядок байтов Intel, называемый «little-Endian», также является обратным порядком сети «big-Endian». В следующей таблице описаны эти термины.
Порядок больших и маленьких байтов
| Порядок байтов | Значение |
|---|---|
| Big-Endian | Самый значительный байт находится в левом конце слова. |
| Маленький эндиан | Самый значительный байт находится в правом конце слова. |
Как правило, вам не нужно беспокоиться о преобразовании байтов для данных, которые вы отправляете и получаете по сети, но существуют ситуации, в которых необходимо преобразовать заказы байтов.
Когда необходимо преобразовать заказы байтов
В следующих ситуациях необходимо преобразовать заказы байтов:
- Вы передаете информацию, которая должна интерпретироваться сетью, а не данные, отправляемые на другой компьютер. Например, можно передать порты и адреса, которые должны понимать сеть.
- Серверное приложение, с которым вы взаимодействуете, не является приложением MFC (и у вас нет исходного кода). Это вызывает преобразования порядка байтов, если два компьютера не используют одинаковый порядок байтов.
Если вам не нужно преобразовывать заказы байтов
Вы можете избежать работы преобразования заказов байтов в следующих ситуациях:
- Компьютеры на обоих концах могут не переключать байты, и оба компьютера используют одинаковый порядок байтов.
- Сервер, с которым вы взаимодействуете, является приложением MFC.
- У вас есть исходный код для сервера, с которым вы взаимодействуете, поэтому вы можете явно определить, нужно ли преобразовать заказы байтов или нет.
- Сервер можно перенести в MFC. Это довольно легко сделать, и результат обычно меньше, быстрее кода.
Работая с CAsyncSocket, необходимо самостоятельно управлять любыми необходимыми преобразованиями порядка байтов. Сокеты Windows стандартизуют модель байтового порядка big-Endian и предоставляет функции для преобразования между этим порядком и другими. Однако CArchive, который вы используете с CSocket, использует противоположный порядок («маленький эндиан»), но CArchive заботится о деталях преобразования байтов для вас. Используя этот стандартный порядок в приложениях или с помощью функций преобразования байтов в сокетах Windows, вы можете сделать код более переносимым.
Идеальным вариантом использования сокетов MFC является написание обоих окончаний взаимодействия: использование MFC в обоих концах. Если вы пишете приложение, которое будет взаимодействовать с приложениями, не являющихся MFC, например FTP-сервером, вам, вероятно, потребуется самостоятельно управлять переключениями байтов перед передачей данных в архивный объект, используя подпрограммы преобразования сокетов Windows ntohs, ntohl, htons и htonl. Пример этих функций, используемых в взаимодействии с приложением, отличным от MFC, отображается далее в этой статье.
Если другой конец связи не является приложением MFC, необходимо также избежать потоковой передачи объектов C++, производных от CObject архива, так как получатель не сможет обрабатывать их. См. примечание в сокетах Windows: использование сокетов с архивами.
Дополнительные сведения о заказах байтов см. в спецификации сокетов Windows, доступной в пакете SDK для Windows.
Пример преобразования байтового порядка
В следующем примере показана функция сериализации для CSocket объекта, использующего архив. Он также иллюстрирует использование функций преобразования байтов в API сокетов Windows.
В этом примере представлен сценарий, в котором вы пишете клиент, который взаимодействует с серверным приложением, отличным от MFC, для которого у вас нет доступа к исходному коду. В этом сценарии необходимо предположить, что сервер, отличный от MFC, использует стандартный порядок байтов сети. В отличие от этого, клиентское приложение MFC использует объект с CSocket объектом и CArchive использует CArchive байтовый порядок «little-Endian», противоположность стандарту сети.
Предположим, что сервер, отличный от MFC, с которым планируется взаимодействовать, имеет установленный протокол для пакета сообщений, как показано ниже:
struct Message < long MagicNumber; unsigned short Command; short Param1; long Param2; >; В терминах MFC это будет выражено следующим образом:
struct Message < long m_lMagicNumber; short m_nCommand; short m_nParam1; long m_lParam2; void Serialize(CArchive &ar); >; В C++, это struct , по сути, то же самое, что и класс. Структура Message может иметь функции-члены, такие как функция-член, объявленная Serialize выше. Функция-член Serialize может выглядеть следующим образом:
void Message::Serialize(CArchive &ar) < if (ar.IsStoring()) < ar else < WORD w; DWORD dw; ar >> dw; m_lMagicNumber = ntohl((long)dw); ar >> w; m_nCommand = ntohs((short)w); ar >> w; m_nParam1 = ntohs((short)w); ar >> dw; m_lParam2 = ntohl((long)dw); > > В этом примере вызывается преобразование данных в порядке байтов, так как существует четкое несоответствие между порядком байтов серверного приложения, отличного от MFC, в одном конце и CArchive используемым в клиентском приложении MFC в другом конце. В этом примере показано несколько функций преобразования байтов, предоставляемых сокетами Windows. В следующей таблице описаны эти функции.
Функции преобразования сокетов Windows Byte-Order
| Функция | Назначение |
|---|---|
| ntohs | Преобразование 16-разрядного количества из сетевого байтового порядка в порядок байтов узла (big-Endian в маленький эндиан). |
| ntohl | Преобразование 32-разрядного количества из байтов сети в порядок байтов узла (big-Endian в маленький эндиан). |
| Хтоны | Преобразование 16-разрядного количества из порядка байтов узла в сетевой порядок байтов (маленький байт в big-Endian). |
| Htonl | Преобразование 32-разрядного количества из порядка байтов узла в сетевой байтовый порядок (маленький байт в big-Endian). |
Еще одна точка этого примера заключается в том, что если приложение сокета в другом конце связи — это приложение, отличное от MFC, необходимо избежать выполнения следующих действий:
где pMsg указатель на объект C++, производный от класса CObject . Это приведет к отправке дополнительных сведений MFC, связанных с объектами, и сервер не поймет его, так как это было бы, если бы это было приложение MFC.
Дополнительные сведения см. в разделе:
- Сокеты Windows. Использование класса CAsyncSocket
- Сокеты Windows. Фон
- Сокеты Windows. Сокеты потоков
- Сокеты Windows. Сокеты датаграмм
Понятие порядка байтов в цифровых системах: прямой (Big Endian) и обратный (Little Endian) порядок байтов
Различные термины «порядка байтов» («endian») могут показаться немного странными, но основная концепция довольно проста. Если вы еще не хорошо знакомы с вариантами порядка байтов, читайте статью дальше!
Порядок байтов, прямой порядок (big endian), обратный порядок (little endian). Что означают эти термины, и как они влияют на работу инженеров?
Что такое порядок байтов?
Оказывает, это неправильный вопрос. При обсуждении данных «порядок байтов» не является отдельным термином. Вернее, к форматам расположения байтов относятся термины «прямой порядок» («big-endian») и «обратный порядок» («little-endian»).
Термины берут начало в «Путешествиях Гулливера» Джонатана Свифта, в которых начинается гражданская война между теми, кто предпочитает разбивать вареные яйца на большом конце («big-endians»), и теми, кто предпочитает разбивать их на маленьком конце («little-endians»).
В 1980 году израильский ученый-компьютерщик Денни Коэн написал статью («О священных войнах и призыве к миру»), в которой он представил насмешливое объяснение столь же мелкой «войны», вызванной одним вопросом:
«Каков правильный порядок байтов в сообщениях?»
Чтобы объяснить эту проблему, он позаимствовал у Свифта термины «big endian» и «little endian», чтобы описать две противоположные стороны дискуссии о том, что он называл «endianness» (в данном контексте «порядок байтов»).
Когда Свифт писал «Путешествия Гулливера» где-то в первой четверти восемнадцатого века, он, конечно, не знал, что однажды его работа послужит вдохновением для неологизмов двадцатого века, которые определяют расположение цифровых данных в памяти и системах связи. Но такова жизнь – часто странная и всегда непредсказуемая.
Зачем нам нужен порядок байтов
Несмотря на сатирическую трактовку Коэном борьбы «big endians» (прямого порядка, от старшего к младшему) против «little endians» (обратного порядка, от младшего к старшему), вопрос о порядке байтов на самом деле очень важен для нашей работы с данными.
Блок цифровой информации – это последовательность единиц и нулей. Эти единицы и нули начинаются с наименьшего значащего бита (least significant bit, LSb – обратите на строчную букву «b») и заканчиваются на наибольшем значащем бите (most significant bit, MSb).
Это кажется достаточно простым; рассмотрим следующий гипотетический сценарий.
32-разрядный процессор готов к сохранению данных и, следовательно, передает 32 бита данных в соответствующие 32 блока памяти. Этим 32 блокам памяти совместно назначается адрес, скажем 0x01. Шина данных в системе спроектирована таким образом, что нет возможности смешивать LSb с MSb, и все операции используют 32-битные данные, даже если соответствующие числа могут быть легко представлены в 16 или даже 8 битами. Когда процессору требуется получить доступ к сохраненным данным, он просто считывает 32 бита с адреса памяти 0x01. Эта система является надежной, и нет необходимости вводить понятие порядка байтов.
Возможно, вы заметили, что слово «байт» в описании этого гипотетического процессора нигде не упоминалось. Всё основано на 32-битных данных – зачем нужно делить эти данные на 8-битные части, если всё оборудование предназначено для обработки 32-битных данных? Вот здесь-то теория и реальность расходятся. Реальные цифровые системы, даже те, которые могут напрямую обрабатывать 32-битные или 64-битные данные, широко использую 8-битный сегмент данных, известный как байт.
Порядок байтов в памяти
Удобным средством демонстрации порядка байтов действии и объяснения разницы между прямым и обратным порядками является процесс хранения цифровых данных. Представьте, что мы используем 8-разрядный микроконтроллер. Всё аппаратное обеспечение в этом устройстве, включая ячейки памяти, предназначено для 8-битных данных. Таким образом, адрес 0x00 может хранить один байт, адрес 0x01 тоже хранит один байт, и так далее.
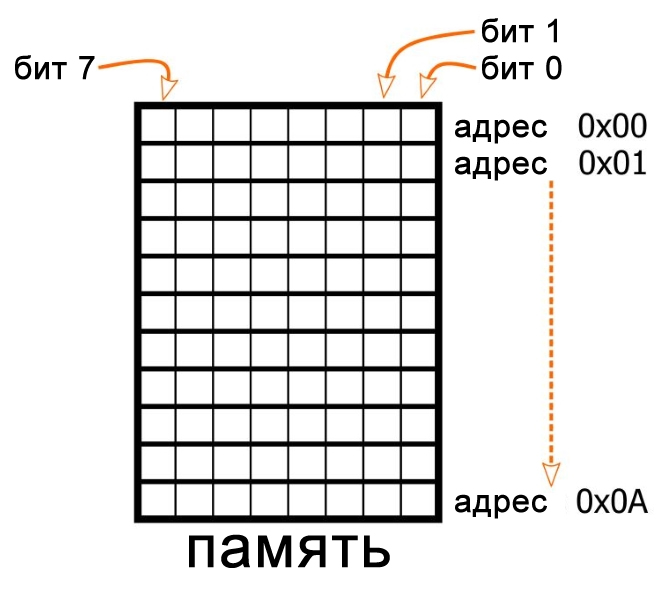
Допустим, мы решили запрограммировать этот микроконтроллер, используя компилятор C, который позволяет нам определять 32-разрядные (т.е. 4-байтовые) переменные. Компилятор должен хранить эти переменные в смежных ячейках памяти, но что не очень понятно, так это то, в самом младшем адресе памяти должен храниться наибольший значащий байт (most significant byte, MSB – обратите внимание на заглавную «B») или наименьший значащий байт (least significant byte, LSB).
Другими словами, должна ли система использовать порядок памяти от старшего к младшему (прямой порядок, big-endian) или от младшего к старшему (обратный порядок, little-endian)?
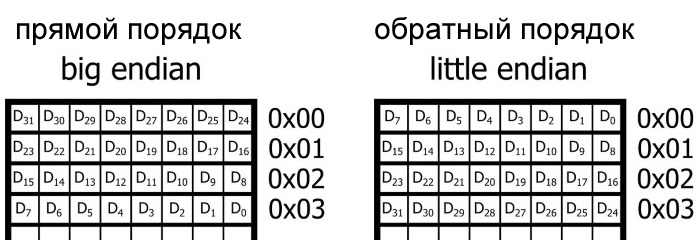
Здесь на самом деле нет правильного или неправильного ответа – любая договоренность может быть совершенно эффективной. Решение между прямым и обратным порядком может быть основано, например, на поддержании совместимости с предыдущими версиями данного процессора, что, конечно, поднимает вопрос о том, как инженеры приняли решение для первого процессора в этом семействе. Я не знаю; возможно, генеральный директор подбросил монету.
Прямой порядок против обратного порядка
Прямой порядок (big endian) указывает на организацию цифровых данных, которая начинается с «большого» конца слова данных и продолжается в направлении «маленького» конца, где «большой» и «маленький» соответствуют наибольшему значащему и наименьшему значащему битам соответственно.
Обратный порядок (little endian) указывает на организацию, которая начинается с «маленького» конца и продолжается в направлении «большого» конца.
Решение между прямым и обратным порядками байтов не ограничивается схемами памяти и 8-разрядными процессорами. Байт является универсальной единицей в цифровых системах. Подумайте только о персональных компьютерах: пространство на жестком диске измеряется в байтах, ОЗУ измеряется в байтах, скорость передачи данных по USB указывается в байтах в секунду (или в битах в секунду), и это несмотря на тот факт, что 8-разрядные персональные компьютеры полностью устарели. Вопрос о порядке байтов вступает в игру всякий раз, когда цифровая система совмещает хранение или передачу данных на основе байтов с числовыми значениями, длина которых превышает 8 бит.
Инженеры должны знать о порядке байтов, когда данные хранятся, передаются или интерпретируются. Последовательная связь особенно восприимчива к проблемам с порядком байтов, поскольку байты, содержащиеся в многобайтовом слове данных, неизбежно будут передаваться последовательно, обычно либо от MSB до LSB, либо от LSB до MSB.
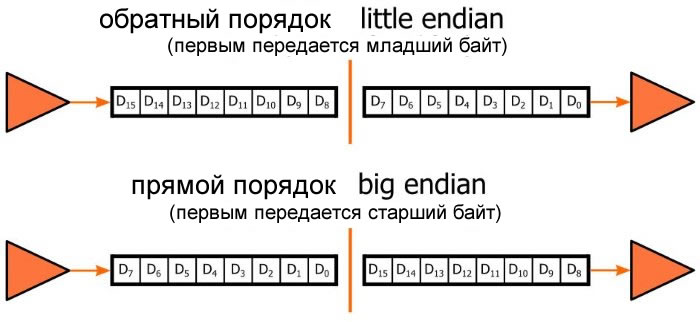
Параллельные шины не защищены от путаницы с порядком байтов, поскольку ширина шины может быть короче ширины данных. И в этом случае прямой или обратный порядок байтов должен быть выбран для параллельной побайтовой передачи данных.
Примером интерпретации на основе порядка байтов является случай, когда байты данных передаются от модуля датчика на ПК через «последовательный порт» (что в настоящее время почти наверняка означает, что в качестве COM порта используется USB соединение). Допустим, всё, что вам нужно сделать, это вывести эти данные, используя какой-то код MATLAB. Когда вы вводите эти байты в среду MATLAB и конвертируете их в обычные переменные, вы должны интерпретировать значения отдельных байтов в соответствии с порядком, в котором они хранятся в памяти.
Заключение
Очень жаль, что универсальная система порядка байтов не была создана еще в начале цифровой эпохи. Я даже не хочу знать, сколько коллективных часов человеческой жизни было посвящено решению проблем, вызванных несовпадающим порядком байтов.
В любом случае, мы не можем изменить прошлое, и мы также вряд ли убедим каждую компанию, производящую полупроводниковую технику и программное обеспечение, пересмотреть свои производственные линии для достижения единого универсального порядка байтов. Что мы можем сделать, так это добиваться согласованности наших собственных проектов и предоставлять четкую документацию, если существует вероятность конфликта между двумя составляющими частями системы.