«Нежданчики» языка Фортран
Многие из нас, обучаясь программированию ещё в университетах или дома, делали это на языках С/С++. Конечно, всё зависит от времени, в которое начиналось наше знакомство с языками программирования. Скажем, кто-то начинал с Фортрана, другие — с Basic’a или Delphi, но стоит признать, что доля начавших свой тернистый путь программиста с С/С++ наибольшая. К чему я всё это? Когда перед нами стоит задача изучить новый язык и написать на нём код, мы часто основываемся на том, как бы я это написал на своём «базовом» языке. Сузим вопрос — если нужно написать что-то на Фортране, то мы вспоминаем, как бы это было реализовано на С и делаем по аналогии. Очередной раз столкнувшись с тонкостью языка, которая привела к абсолютно неработающему алгоритму и большой проблеме, эскалированной мне, я решил отыскать как можно больше нюансов языка Фортран (Fortran 90/95), по сравнению с С, с которыми столкнулся лично. Это своего рода «нежданчики», которые ты явно не планировал увидеть, а они бац – и всплыли!
Конечно, речь не пойдёт о синтаксисе — в каждом языке он свой. Я попробую рассказать о глобальных вещах, способных изменить всё «с ног на голову». Поехали!
Передача аргументов в функции
Все мы помним, что таким кодом на С изменить значение переменной a в вызывающей main функции нельзя:
void modify_a(int a) < a = 6; >int main()
Всё правильно – аргументы в функцию в языке С передаются по значению, таким образом изменить a в функции modify_a не получится. Для этого нужно передать аргумент по ссылке и тогда мы будет работать с той самой a, переданной из вызываемой функции.
Так вот, «нежданчик» номер «раз» заключается в том, что в Фортране всё наоборот! Аргументы передаются в функции по ссылке, и подобный код вполне будет изменять значение a:
a = 5 call modify_a (a) contains subroutine modify_a (a) integer a a = 6 end subroutine modify_a end Думаю, что все понимают проблемы, которые могут появиться от незнания данного факта. Причем проявляться эта специфика может много где, в частности, при работе с указателями, но об этом будет отдельный разговор.
Работа с массивами
По дефолту, индексация массивов в Фортране начинается с 1, а не с 0, как в С. То есть real a(10) дает нам массив от 1 до 10, а в С float a[10] идет от 0 до 9. Тем не менее, мы можем задать массив и как real a(0:100) в Фортране.
Кроме того, многомерные массивы хранятся в памяти в Фортране по столбцам. Таким образом обычная матрица

располагается в памяти так:
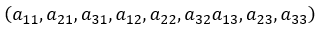
Не забываем об этом при работе с массивами, особенно, если передаем их в/из функции на С через библиотеки.
Необъявленные переменные
Фортран по умолчанию не будет ругаться на данные, которые мы не объявили явно, потому как здесь есть понятие неявных типов данных. Пошло это с стародавних времён, и идея заключается в том, что мы сразу можем работать с данными, а тип у них будет определяться в зависимости от первой буквы в имени – во как хитро!
Попытка собрать код с компилятором С предсказуемо выдаст ошибку ‘b: undeclared identifier’:
int main()
В Фортране сработает на ура:
i = 5 end Сколько же абсолютно разноплановых ошибок в коде может быть от этого. Поэтому, не забываем добавлять в код IMPLICIT NONE, запрещающее подобные «игры» с неявными объявлениями:
implicit none i = 5 end И сразу видим ошибку: error #6404: This name does not have a type, and must have an explicit type. [I]
Кстати, язык Фортран не требователен к регистру, поэтому переменные a и A – это одно и то же. Но это уже синтаксис, о котором я обещался не говорить.
Инициализация локальных переменных
Казалось бы, чем подобная инициализация может быть плоха:
real :: a = 0.0 И чем она отличается от такой:
real a a = 0.0 Неожиданный сюрприз для разработчиков на С – в Фортране есть принципиальное различие в этом! Если локальная переменная инициализируется в момент декларации, то к ней неявно применяется атрибут SAVE. Что это за атрибут? Если переменная объявлена как SAVE (явно или неявно), то она является статической, а значит инициализируется только при первом заходе в функцию. При последующих входах в функцию сохраняется предыдущее значение. И это может быть совсем не тем, что мы ожидаем. Как совет – избегать подобных инициализаций, и при необходимости использовать атрибут SAVE явно. Кстати, у компилятора даже есть отдельная опция -save, позволяющая менять настройки по умолчанию (выделение на стэке) и делать все переменные статическими (кроме случаев рекурсивных функций и тех переменных, которые явно объявлены как AUTOMATIC).
Указатели
Да, в Фортране тоже есть понятие указателей. Но используются они гораздо реже, потому что выделять память динамически в нем можно и без их помощи, а аргументы и так передаются по ссылке. Стоит отметить, что механизм указателей сам по себе работает в Фортране по-другому, поэтому остановлюсь подробней на этом.
Здесь нельзя сделать указатель на любой объект – только на тот, который объявлен специальным образом. Например, так:
real, target :: a real, pointer :: pa pa => a С помощью оператора => мы ассоциируем указатель pa с объектом a. Не стоит пытаться выполнить операцию присваивания вместо =>. Всё успешно соберётся, но упадёт в рантайме. Так что тем, кто привык просто присваивать указатели в С придётся заставлять писать каждый раз => вместо =. Сначала забываешь, но потом втягиваешься.
Если хотим, чтобы указатель не был ассоциирован с объектом, используем nullify(pa) – это своего рода и инициализация указателя. Когда мы просто объявляем указатель, его статус в Фортране неопределен, и функция, проверяющая его ассоциацию с объектами (associated(pa)) будет работать некорректно.
Кстати, почему нельзя ассоциировать указатель с любой переменной того же типа, как это делается в С? Во-первых, так захотелось в комитете по стандартизации. Шучу. Скорее всего, всё дело в ещё одном уровне защиты от потенциальных ошибок – просто так мы теперь точно не сможем связать указатель со случайной переменной, ну и подобное ограничение дает компилятору больше информации, а, следовательно, больше возможностей для оптимизации кода.
Кроме того, что тип указателя и объекта должны совпадать, а сам объект должен быть объявлен с атрибутом TARGET, есть ещё ограничение и на размерность массивов. Скажем, если мы работаем с одномерными массивами, то и указатель должен быть объявлен соответствующим образом:
real, target :: b(1000) real, pointer :: pb(:) Если бы массив был двумерный, то указатель бы был pb(. ). Естественно, что размер массива в указателе не задается – мы же не знаем, с каким массивом будет ассоциирован указатель. Думаю, логика понятна. После ассоциации, мы можем работать с указателем как обычно:
b(i) = pa*b(i+1) Что то же самое, что написать b(i) = a*b(i+1). Можно и значение присвоить, например pa = 1.2345.
Таким образом, значение у a будет 1.2345. Интересная особенность указателей Фортрана заключается в том, что с их помощью можно работать с частью массива.
Если мы написали b => pb, то можем работать с 1000 элементами массива b через указатель pb.
Но можно написать и так:
pb => b(201:300) В этом случае мы будем работать с массивом только из 100 элементов, а pb(1) – это b(201).
Забавно, как можно использовать функцию выделения памяти allocate в случае указателей. Написав allocate(pb(20)) мы выделим дополнительно 20 элементов массива типа real, которые будут доступны только через указатель pb.
Вообщем, человеку привыкшему к С, всё это будет казаться необычным. Но, если начать писать код, то достаточно быстро привыкаешь, и всё начинает казаться удобным.
Разработчик, натолкнувший меня на идею написания этого блога, тоже так думал и активно работал с указателями направо и налево, создавая код, алгоритм которого использует дерево, но не учитывал одну особенность. На Фортран переписывался этот Сишный код:
void rotate_left(rbtree t, node n) < node r = n->right; . У структуры node есть поля, содержащие указатели node*, например right.
В функции создается локальная переменная r, ей присваивается значение n->right и так далее и тому подобное. Реализация на Фортране получилась такой:
subroutine rotate_left(t, n) type(rbtree_t) :: t type(rbtree_node_t), pointer :: n type(rbtree_node_t), pointer :: r r => n%right . И вот тут, в самом начале, кроется «ошибка ошибок». Мы ассоциировали указатель r с n%right. Изменяя в дальнейшем коде r, мы будем менять и n%right, в отличие от С, где будет изменяться только локальная переменная r. В итоге, всё дерево превратилось непонятно во что. Выход из ситуации — ещё один локальный указатель:
subroutine rotate_left(t, n_arg) type(rbtree_t) :: t type(rbtree_node_t), pointer :: n_arg type(rbtree_node_t), pointer :: r type(rbtree_node_t), pointer :: n n => n_arg r => n%right . В этом случае, если мы в дальнейшем меняем ассоциацию у указателя n, то это никак не затронет «внешний» n_arg.
Стринги
Ну и напоследок, одна маленькая особенность, попортившая огромное количество памяти в mixed приложениях (С и Фортран). Как вы думаете, в чем может быть разница при работе с стрингами в С:
char string[80]="test"; И Фортране:
character(len=80) :: string string = "test" Ответ легко поможет дать отладчик. В этом случае, в Фортране оставшиеся неиспользованными байты забиваются пробелами. При этом нет типичного для С символа окончания строки /0, поэтому нужно быть предельно аккуратным, передавая стринги из Фортрана в С и обратно. Опять скажу, что для того, чтобы безопасно работать с С и Фортраном, нужно использовать специальный модуль ISO_C_BINDING, который разрешает и данное различие, и много других проблем.
На этом заканчиваю свой рассказ. Теперь вы точно знаете самые важные различия между С и Фортраном, и если уж придётся написать код на последнем, я думаю, сделаете это не хуже, чем на С, правда? Ну а данный пост будет в помощь.
- Блог компании Intel
- Программирование
- Компиляторы
- Fortran
Неинициализированные переменные: ищем ошибки

Большое количество научных исследований используют код, написанный на языке Фортран. И, к великому сожалению, «научные» приложения тоже не застрахованы от банальных ошибок, таких как неинициализированные переменные. Стоит ли говорить, к чему могут приводить подобные вычисления? Иногда эффект от таких ошибок может довести до «серьёзных прорывов» в науке, или стать причиной действительно больших проблем – кто знает где полученные результаты могут быть использованы (но, мы догадываемся где)? Хотелось бы привести ряд простых и эффективных методов, которые позволят проверить существующий код на Фортране с помощью компилятора Intel и избежать подобных неприятностей.
Мы будем рассматривать проблемы, связанные с числами с плавающей точкой. Ошибки с неинициализированными переменными достаточно трудно находимы, особенно, если код начинали писать на стандарте Fortran 77. Специфика заключается в том, что даже если мы не объявили переменную, она будет объявляться неявно, в зависимости от первой буквы имени, по, так называемым, правилам неявного определения типов (всё это так же поддерживается в последних стандартах). Буквы от I до N означают тип INTEGER, а остальные буквы — тип REAL. То есть, если в нашем коде неожиданно появляется переменная F, на которую мы что-то умножаем, компилятор не будет выдавать ошибок, а просто сделает F вещественным типом. Вот такой замечательный пример может вполне хорошо скомпилироваться и выполниться:
program test z = f*10 print *, z, f end program test Как вы понимаете, на экране будет всё, что угодно. У меня так:
-1.0737418E+09 -1.0737418E+08 Интересно, что в том же стандарте была возможность подобные «игры» с объявлением переменных запрещать, но только в пределах программной единицы, написав implicit none. Правда, если забыть это сделать в каком-то модуле, там так и будут появляться «фантомные» переменные. Любопытно, что я как-то раз видел случайно добавленные символы к имени переменной в расчётах. Видимо, кто-то случайно набирал что-то в блокноте, и часть из них добавилась в код программы при переключении между окнами. В итоге, всё продолжало считаться, и на переменную никто не ругался. Отследить подобные ошибки крайне сложно, особенно если код долгие годы работал без проблем.
Поэтому, очень рекомендую всегда использовать implicit none и получать ошибки от компилятора о переменных, которые не были явно определены (даже если они и инициализированы и с ними всё хорошо):
program test implicit none . end program test error #6404: This name does not have a type, and must have an explicit type. [Z] error #6404: This name does not have a type, and must have an explicit type. [F] Если же мы разбираемся в уже написанном коде, то менять все исходники может быть весьма трудозатратно, поэтому можно воспользоваться опцией компилятора /warn:declarations(Windows) или -warn declarations(Linux). Она выдаст нам предупреждения:
warning #6717: This name has not been given an explicit type. [Z] warning #6717: This name has not been given an explicit type. [F] Когда мы разберёмся со всеми неявными объявленными переменными и убедимся, что ошибок с ними нет, можно переходить к следующей части «Марлезонского балета», а именно поиском неинициализированных переменных.
Одним из стандартных способов является инициализация компилятором всех переменных некоторым значением, по которому, при работе с переменной, мы сможем легко понять, что разработчик забыл про инициализацию. Значение это должно быть весьма «необычным», а при работе с ним, желательно, останавливать выполнение приложения, чтобы, так сказать, «взять с поличным».
Весьма логичным является использование «сигнальным» значением SNaN — Signaling NaN (Not-a-Number). Это число с плавающей точкой, имеющее особое представление, и при попытке выполнить любую операцию с ним, мы получим исключение. Стоит сказать, что некая переменная может получить значение NaN и при выполнении определенных операция, например, делении на нуль, умножении нуля на бесконечность, делении бесконечности на бесконечность и так далее. Поэтому, прежде чем переходить к «отлову» неинициализированных переменных, хотелось бы убедиться, что в нашем коде нет никаких исключений, связанных с работой с числами с плавающей точкой.
Для этого нужно включить опцию /fpe:0 и /traceback (Windows), или –fpe0 и –traceback (Linux), собрать приложение и запустить его. Если всё прошло как обычно, и приложение вышло без генерации исключения, то мы молодцы. Но, вполне возможно, что уже на этом этапе «полезут» разные «непредвиденные моменты». А всё потому, что fpe0 меняет дефолтную работу с исключениями для чисел с плавающей точкой. Если по умолчанию они отключены, и мы спокойно делим на 0, не подозревая об этом, то теперь, будет происходить генерация исключения и остановка выполнения программы. Кстати, не только при делении на 0 (divide-by-zero), но и при переполнении числа с плавающей точкой (floating point overflow), а так же при недопустимых операциях (floating invalid). При этом, численные результаты могут также несколько измениться, так как теперь денормализованные числа будут «сбрасываться» в 0. Это, в свою очередь, может дать весомое ускорение при выполнении вашего приложения, так как с денормализованными числами работа происходит крайне медленно, ну а с нулями – сами понимаете.
Ещё один интересный момент – возможное получение исключений с опцией fpe0 в результате определённых компиляторных оптимизаций, например, векторизации. Скажем, мы в цикле и делили на значение, если оно не 0, делая проверку if. Возможна ситуация, когда деление всё же будет происходить, потому что компилятор решил, что это будет значительно быстрее, чем использовать маскированные операции. В данном случае мы работаем в спекулятивном режиме.
Так вот это можно контролировать с помощью опции /Qfp-speculation:strict (Windows) или -fp-speculation=strict (Linux), и отключать подобные оптимизации компилятора при работе с числами с плавающей точкой. Другой способ – изменить всю модель работы через -fp-model strict, что даёт большой отрицательный эффект на общую производительность приложения. Про то, какие модели имеются в компиляторе Intel я уже рассказывал ранее.
Кстати, можно поробовать и просто уменьшить уровень оптимизации через опции /O1 или /Od на Windows (-O1 и -O0 на Linux).
Опция traceback просто позволяет получить более детальную информацию о том, где произошла ошибка (имя функции, файл и строчка кода).
Давайте сделаем тест на Windows, скомпилировав без оптимизации (с опцией /Od):
program test implicit none real a,b a=0 b = 1/a print *, 'b=', b end program test В итоге на экране мы увидим следующее:
b= Infinity Теперь включаем опцию /fpe:0 и /traceback и получаем ожидаемый exception:
forrtl: error (73): floating divide by zero Image PC Routine Line Source test.exe 00F51050 _MAIN__ 5 test.f90 … Такие проблемы нам нужно убрать из нашего кода до начала следующего этапа, а именно, принудительной инициализации значениями SNaN с помощью опции /Qinit:snan,arrays /traceback (Windows) или -init=snan,arrays -traceback (Linux).
Теперь каждый доступ к неинициализированной переменной приведёт к ошибке времени выполнения:
forrtl: error (182): floating invalid - possible uninitialized real/complex variable. На простейшем примере:
program test implicit none real a,b b = 1/a print *, 'b=', b end program test forrtl: error (182): floating invalid - possible uninitialized real/complex variable. Image PC Routine Line Source test.exe 00D01061 _MAIN__ 4 test.f90 … Немного слов о том, что это за диковинная опция init. Появилась она не так давно, а именно с версии компилятора 16.0 (напомню, что последняя версия компилятора на сегодня – 17.0), и позволяет инициализировать в SNaN следующие конструкции:
- Статические скаляры и массивы (с атрибутом SAVE)
- Локальные скаляры и массивы
- Автоматические (образуемые при вызове функций) массивы
- Переменные из модулей
- Динамически выделяемые (с атрибутом ALLOCATABLE) массивы и скаляры
- Указатели (переменные с атрибутом POINTER)
- Переменные в группах EQUIVALENCE
- Переменные в COMMON блоке
- Наследуемые типы и их компоненты не поддерживаются, кроме ALLOCATABLE и POINTER
- Формальные (dummy) аргументы в функциях не инициализируются в SNaN локально. Тем не менее, фактические аргументы, передаваемые в функцию могут быть инициализированы в вызывающей функции.
- Ссылки в аргументах интринсик-функций и выражениях I/O
-init=snan,zero ! Linux and OS X systems /Qinit:snan,zero ! Windows systems Инициализируют скаляры типов REAL или COMPLEX значением SNaN, а типы INTEGER или LOGICAL нулями. Следующий пример расширяет действие инициализации ещё и на массивы:
-init=zero -init=snan –init=arrays ! Linux and OS X systems /Qinit:zero /Qinit:snan /Qinit:arrays ! Windows systems В прошлом Intel пытался реализовать подобный функционал через опцию -ftrapuv, но на сегодняшний день она не рекомендуется к использованию и устарела, хотя по задумке, тоже должна была инициализировать значения — не сложилось.
Кстати, если вы работаете на сопроцессоре Intel Xeon Phi первого поколения (Knights Corner), то опция будет недоступна для вас, так как там нет поддержки SNaN.
Ну и в конце, примерчик из документации, который мы скомпилируем на Linux со всеми предложенными опциями и найдём неинициализированные переменные в рантайме:
! ============================================================== ! ! SAMPLE SOURCE CODE - SUBJECT TO THE TERMS OF SAMPLE CODE LICENSE AGREEMENT, ! http://software.intel.com/en-us/articles/intel-sample-source-code-license-agreement/ ! ! Copyright 2015 Intel Corporation ! ! THIS FILE IS PROVIDED "AS IS" WITH NO WARRANTIES, EXPRESS OR IMPLIED, INCLUDING BUT ! NOT LIMITED TO ANY IMPLIED WARRANTY OF MERCHANTABILITY, FITNESS FOR A PARTICULAR ! PURPOSE, NON-INFRINGEMENT OF INTELLECTUAL PROPERTY RIGHTS. ! ! =============================================================== module mymod integer, parameter :: n=100 real :: am real, allocatable, dimension(:) :: dm real, target, dimension(n) :: em real, pointer, dimension(:) :: fm end module mymod subroutine sub(a, b, c, d, e, m) use mymod integer, intent(in) :: m real, intent(in), dimension(n) :: c real, intent(in), dimension(*) :: d real, intent(inout), dimension(*) :: e real, automatic, dimension(m) :: f real :: a, b print *, a,b,c(2),c(n/2+1),c(n-1) print *, d(1:n:33) ! first and last elements uninitialized print *, e(1:n:30) ! middle two elements uninitialized print *, am, dm(n/2), em(n/2) print *, f(1:2) ! automatic array uninitialized e(1) = f(1) + f(2) em(1)= dm(1) + dm(2) em(2)= fm(1) + fm(2) b = 2.*am e(2) = d(1) + d(2) e(3) = c(1) + c(2) a = 2.*b end program uninit use mymod implicit none real, save :: a real, automatic :: b real, save, target, dimension(n) :: c real, allocatable, dimension(:) :: d real, dimension(n) :: e allocate (d (n)) allocate (dm(n)) fm => c d(5:96) = 1.0 e(1:20) = 2.0 e(80:100) = 3.0 call sub(a,b,c,d,e(:),n/2) deallocate(d) deallocate(dm) end program uninit Сначала, компилируем с –fpe0 и запускаем:
$ ifort -O0 -fpe0 -traceback uninitialized.f90; ./a.out 0.0000000E+00 -8.7806177E+13 0.0000000E+00 0.0000000E+00 0.0000000E+00 0.0000000E+00 1.000000 1.000000 0.0000000E+00 2.000000 0.0000000E+00 0.0000000E+00 3.000000 0.0000000E+00 0.0000000E+00 0.0000000E+00 1.1448686E+24 0.0000000E+00 Видно, что никаких исключений, связанных с операциями надо числами с плавающей точкой в нашем приложении нет, но есть несколько «странных» значений. Будем искать неинициализированные переменные с опцией init:
$ ifort -O0 -init=snan -traceback uninitialized.f90; ./a.out NaN NaN 0.0000000E+00 0.0000000E+00 0.0000000E+00 0.0000000E+00 1.000000 1.000000 0.0000000E+00 2.000000 0.0000000E+00 0.0000000E+00 3.000000 NaN 0.0000000E+00 0.0000000E+00 1.1448686E+24 0.0000000E+00 forrtl: error (182): floating invalid - possible uninitialized real/complex variable. Image PC Routine Line Source a.out 0000000000477535 Unknown Unknown Unknown a.out 00000000004752F7 Unknown Unknown Unknown a.out 0000000000444BF4 Unknown Unknown Unknown a.out 0000000000444A06 Unknown Unknown Unknown a.out 0000000000425DB6 Unknown Unknown Unknown a.out 00000000004035D7 Unknown Unknown Unknown libpthread.so.0 00007FC66DD26130 Unknown Unknown Unknown a.out 0000000000402C11 sub_ 39 uninitialized.f90 a.out 0000000000403076 MAIN__ 62 uninitialized.f90 a.out 00000000004025DE Unknown Unknown Unknown libc.so.6 00007FC66D773AF5 Unknown Unknown Unknown a.out 00000000004024E9 Unknown Unknown Unknown Aborted (core dumped) Теперь видно, что на строчке 39 мы обращаемся к неинициализированный переменной AM из модуля MYMOD:
b = 2.*am В этом коде есть и другие ошибки, которые я предлагаю найти самим с помощью компилятора Intel. Очень надеюсь, что данный пост будет полезен всем, кто пишет код на Фортране, и ваши приложения пройдут необходимые проверки на неинициализированные переменные ещё до выхода «в свет». На этом спасибо за внимание и до скорых встреч! Всех с наступающим Новым Годом!
Implicit none фортран что это
высокого уровня (на примере FORTRAN)
Язык программирования – это набор правил, согласно которым можно записать алгоритм для дальнейшей обработки его компилятором (compiler) и редактором связей (linker). Программа, с точки зрения компьютера, это последовательность действий. Программа состоит из операторов (statements). Операторы делятся на исполняемые и неисполняемые . Исполняемые операторы как раз и определяют действия, в то время как неисполняемые определяют разные программные атрибуты, такие как размещение (arrangement) и характеристики данных, а также информацию для преобразования данных (data-conversion) и другие свойства и особенности.
Формат записи исходного текста
Несколько слов о правилах записи программы. Представьте тетрадку в клетку. Каждая клетка – позиция для одного символа. Существует два формата записи программ на Фортране. В старом формате – FIXED (фиксированный) – позиции (клетки) с 1 по 5 служат для записи метки – номера оператора, по которому вы сможете вернуться к нему в программе или сослаться на него. С 7 по 73 – поле операторов, после – комментарии. В 6-ой позиции ставится любой символ для обозначения продолжения предыдущей строки, если оператор не уместился на ней. Для записи комментариев ставится символ «С» в первой позиции строки, далее до конца строки любой текст считается комментарием и игнорируется компилятором.
Новый формат – FREE (свободный). Нет ограничений на расположение оператора на строке. Метка ставится перед оператором через пробел. Допускается запись нескольких операторов на одной строке – разделителем является символ ”;”. Для продолжения оператора на следующей строке необходимо в конце поставить символ ”&”. В свободном формате пробелы (в ключевых словах) являются значимыми. Комментарий – символ ”!” в любой позиции, далее до конца строки любой текст считается комментарием и игнорируется компилятором.
Меткалф рекомендует следующие правила для совместимости программы в свободном и фиксированном формате:
размещать метки в позициях с 1-ой по 5-ю, а операторы — с 7-ой по 72-ю;
Требования к оформлению программы — правило рельефа. Если оператор содержиться внутри блока (например, в теле цикла, или в блочном усл. операторе), то его начало должно отступать как минимум на одну позицию вправо от оператора начала блока.
do i=1,5 print '(i5,\)',i end do print *
Порядок следования операторов в ПБ.
На схеме показан требуемый порядок операторов в Программном Блоке ( ПБ ) Fortran. Вертикальные линии отделяют типы операторов, которые могут чередоваться. Горизонтальные линии отделяют типы операторов, которые не могут чередоваться.
Фортран – Типы данных
Целочисленные типы могут содержать только целочисленные значения. В следующем примере извлекается наибольшее значение, которое может содержаться в обычном четырехбайтовом целом числе:
program testingInt implicit none integer :: largeval print *, huge(largeval) end program testingInt
Когда вы компилируете и запускаете вышеуказанную программу, она дает следующий результат –
2147483647
Обратите внимание, что функция large () выдает наибольшее число, которое может содержаться конкретным целочисленным типом данных. Вы также можете указать количество байтов, используя спецификатор вида . Следующий пример демонстрирует это –
program testingInt implicit none !two byte integer integer(kind = 2) :: shortval !four byte integer integer(kind = 4) :: longval !eight byte integer integer(kind = 8) :: verylongval !sixteen byte integer integer(kind = 16) :: veryverylongval !default integer integer :: defval print *, huge(shortval) print *, huge(longval) print *, huge(verylongval) print *, huge(veryverylongval) print *, huge(defval) end program testingInt
Когда вы компилируете и запускаете вышеуказанную программу, она дает следующий результат –
32767 2147483647 9223372036854775807 170141183460469231731687303715884105727 2147483647
Реальный тип
Он хранит числа с плавающей запятой, такие как 2.0, 3.1415, -100.876 и т. Д.
Традиционно есть два различных реальных типа, реальный тип по умолчанию и тип двойной точности .
Однако Fortran 90/95 обеспечивает больший контроль над точностью реальных и целочисленных типов данных с помощью спецификатора вида , который мы изучим в главе о числах.
В следующем примере показано использование реального типа данных –
program division implicit none ! Define real variables real :: p, q, realRes ! Define integer variables integer :: i, j, intRes ! Assigning values p = 2.0 q = 3.0 i = 2 j = 3 ! floating point division realRes = p/q intRes = i/j print *, realRes print *, intRes end program division
Когда вы компилируете и запускаете вышеуказанную программу, она дает следующий результат –
0.666666687 0
Комплексный тип
Это используется для хранения комплексных чисел. Комплексное число состоит из двух частей: действительной части и мнимой части. Два последовательных цифровых запоминающих устройства хранят эти две части.
Например, комплексное число (3,0, -5,0) равно 3,0 – 5,0i
Мы обсудим сложные типы более подробно в главе Numbers.
Логический тип
Есть только два логических значения: .true. и .false.
Тип персонажа
Тип символа хранит символы и строки. Длина строки может быть указана спецификатором len. Если длина не указана, это 1.
character (len = 40) :: name name = “Zara Ali”
Выражение name (1: 4) даст подстроку «Zara».
Неявная печать
В старых версиях Fortran допускалась функция, называемая неявной типизацией, т. Е. Вам не нужно объявлять переменные перед использованием. Если переменная не объявлена, то первая буква ее имени будет определять ее тип.
Имена переменных, начинающиеся с i, j, k, l, m или n, считаются целочисленными, а другие – действительными переменными. Однако вы должны объявить все переменные, так как это хорошая практика программирования. Для этого вы начинаете свою программу с заявления –
implicit none
Это утверждение отключает неявную типизацию.