Предобработка данных на Python

Анализ данных является довольно сложным, увлекательным и часто требующим креативности от исполнителя процессом. Важным и первостепенным этапом проведение анализа является подготовка данных. Именно этому этапу, от которого зависит скорость, удобство, а также результат, и посвящен мой пост.
Публикация выполнена в виде инструкции с пошаговым прогрессом. Пороговый вход для понимания материала невысокий, но кое-что все же нужно знать:
- типы данных;
- вызов библиотек;
- конструктор для таблиц DataFrame;
- срезы данных.
Исходные данные:
На входе у нас есть Data Frame с данными о поле (м или ж), возрасте, контактной информацией, а также признаком. Для тех, кто не любит абстрагироваться, признак – это ответ на вопрос «Играете ли вы в компьютерные игры?» и он может принимать одно из двух значений (да или нет).
Шаг 1. Знакомство с данными
На первом этапе важно посмотреть, что за данные у нас на руках: какие столбцы, какие типы данных, какие они принимают значения.
Выведем первые строки методом head():
df.head()
Посмотрим сводную информацию методом info():
df.info()
Метод info() дает много информации, из которой мы узнаем, что в таблице 20 строк, 4 столбца, видим типы данных для каждого столбца и количество ненулевых значений.
Шаг 2. Переименование столбцов
Является необязательным шагом, но он делает дальнейшие действия более удобными, а внешний вид приятным. Обычной рекомендацией для названия столбцов является: применение латиницы в названии, нижний регистр, а также отсутствие пропусков в имени столбца (заменяется на символ «_»). Для переименования столбцов применим метод set_axis():
col_name = ['tag', 'gender', 'age', 'phone_num'] df.set_axis(col_name, axis = 'columns', inplace = True) 
Шаг 3. Пропуски данных
В зависимости от решаемых задач, пропущенные значения могут быть либо удалены методом dropna(). Может быть удален как столбец, в котором есть хоть одно пропущенное значение, так и строка.
- dropna() – удаление строк, где есть пропущенные значения.
- dropna(subset=[‘col1’, ‘col2’], inplace=True) – удаление строк, где есть пропущенные значения в определенных столбцах (subset).
- dropna(axis=’col1′, inplace=True) – для удаления столбцов с пропущенными значениями.
В зависимости от данных и решаемой задачи пропущенные значения могут быть заменены на характерные значения: среднее арифметическое или медиана. Также стоит отметить, что пропущенные значения могут «маскироваться» (например под None), для определения этого, можно сначала выполнить поиск уникальных значений методом unique().
Удалим все строки, в которых пропущено значение в столбце ‘tag’ методом dropna():
df.dropna(subset = ['tag'], inplace=True)Заменим пропущенный возраст ‘age’, на средний возраст, характерный для определенного пола с определенным признаком, но перед этим проверим какие уникальные значения принимаются в данном столбце. Затем применим метод replace() к значениям ‘None’ и заменим их на NaN:
df.age.unique()
df.age = df.age.replace('None', np.nan)Выведем на экран срез данных с пропущенными значениями в столбце ‘age’ применив метод isnull():
df[df['age'].isnull() == True]
Заменим пропущенные значения методом fillna() на средний возраст играющих в компьютерные игры мужчин (пропущенные значения соответствуют этим признакам):
mean_age = round(df[(df['tag'] == 'да') & (df['gender'] == 'м')]['age'].mean()) print(mean_age) 
df['age'] = df['age'].fillna(mean_age)Шаг 4. Дубликаты
Для нахождения дубликатов применяется метод duplicated(), совместно с методом sum() можно определить количество дубликатов.
Для удаления дубликатов используем методом следующую конструкцию:
drop_duplicates().reset_index(drop=True)Метод reset_index() необходим для изменения индексации, так как drop_duplicates() вместе со строками удаляет и их индексы.
Проверим наличие дубликатов:
df[df.duplicated() == True]
df.duplicated().sum()
Удалим дубликаты и проверим результат:
df = df.drop_duplicates().reset_index(drop=True) df.duplicated().sum() 
Шаг 5. Изменение типов данных
Проверим как сейчас выглядят наши данные. Для просмотра типа данных воспользуемся атрибутом dtypes:
df.head(2)
df.dtypes
Для того, чтобы они стали более «нарядными», нужно изменить тип данных в столбцах ‘age’ и ‘phone_num’ на int.
Для перевода значений формата string в числовой формат применяется метод библиотеки Pandas to_numeric(). От значения errors метода to_numeric(), зависят действия при работе с некорректным значением:
- errors=’raise’ — выдается ошибка, операция прерывается;
- errors=’coerce’ — некорректные значения заменяются на NaN;
- errors=’ignore’ — некорректные значения игнорируются, но остаются.
Применим метод to_numeric() к столбцу ‘phone_num’:
df['phone_num'] = pd.to_numeric(df['phone_num'], errors='coerce') df.dtypes 
Для того, чтобы перевести данные в нужный тип, применяется метод astype():
df['phone_num'] = df['phone_num'].astype('int64')При вызове метода была получена ошибка:

Она возникает, когда в столбце есть данные, принимающие значения NaN. Решением может быть или замена NaN на 0, или на NA. Заменим на NA и поменяем типы данных в нужных столбцах:
df['phone_num'] = df['phone_num'].fillna(pd.NA) df['phone_num'] = df['phone_num'].astype('Int64') df['age'] = df['age'].astype('Int64') Посмотрим на достигнутый результат:
df.info()
df.head(2)
Можно считать задачу решенной, данные подготовлены к дальнейшему анализу.
Заключение
На этом пост подошел к концу, вспомним чему мы научились:
- Знакомиться с общей информацией, находящейся в таблице.
- Переименовывать столбцы.
- Работать с пропусками.
- Находить и удалять дубликаты.
- Менять тип данных.
Как найти дубликаты в Pandas DataFrame(с примерами)
Вы можете использовать функцию Duplicated () для поиска повторяющихся значений в кадре данных pandas.
Эта функция использует следующий базовый синтаксис:
#find duplicate rows across all columns duplicateRows = df[df.duplicated ()] #find duplicate rows across specific columns duplicateRows = df[df.duplicated(['col1', 'col2'])] В следующих примерах показано, как использовать эту функцию на практике со следующими пандами DataFrame:
import pandas as pd #create DataFrame df = pd.DataFrame() #view DataFrame print(df) team points assists 0 A 10 5 1 A 10 5 2 A 12 7 3 A 12 9 4 B 15 12 5 B 17 9 6 B 20 6 7 B 20 6 Пример 1. Поиск повторяющихся строк во всех столбцах
В следующем коде показано, как найти повторяющиеся строки во всех столбцах DataFrame:
#identify duplicate rows duplicateRows = df[df.duplicated ()] #view duplicate rows duplicateRows team points assists 1 A 10 5 7 B 20 6 Есть две строки, которые являются точными копиями других строк в DataFrame.
Обратите внимание, что мы также можем использовать аргумент keep=’last’ для отображения первых повторяющихся строк вместо последних:
#identify duplicate rows duplicateRows = df[df.duplicated (keep='last')] #view duplicate rows print(duplicateRows) team points assists 0 A 10 5 6 B 20 6 Пример 2. Поиск повторяющихся строк в определенных столбцах
В следующем коде показано, как найти повторяющиеся строки только в столбцах «команда» и «точки» в DataFrame:
#identify duplicate rows across 'team' and 'points' columns duplicateRows = df[df.duplicated(['team', 'points'])] #view duplicate rows print(duplicateRows) team points assists 1 A 10 5 3 A 12 9 7 B 20 6 Есть три строки, в которых значения столбцов «команда» и «очки» являются точными копиями предыдущих строк.
Пример 3. Поиск повторяющихся строк в одном столбце
В следующем коде показано, как найти повторяющиеся строки только в столбце «команда» DataFrame:
#identify duplicate rows in 'team' column duplicateRows = df[df.duplicated(['team'])] #view duplicate rows print(duplicateRows) team points assists 1 A 10 5 2 A 12 7 3 A 12 9 5 B 17 9 6 B 20 6 7 B 20 6 Всего имеется шесть строк, в которых значения в столбце «команда» являются точными копиями предыдущих строк.
Дополнительные ресурсы
В следующих руководствах объясняется, как выполнять другие распространенные операции в pandas:
Как найти дубликаты в векторе датафрейм?
Датафрейм состоит из векторов ‘cleanUrl’ и ‘code_url’ Где ‘cleanUrl’ ссылка, а ‘code_url’ ссылка преобразованная в число с помощью:
from sklearn import preprocessing le = preprocessing.LabelEncoder() Пример файла:
cleanUrl,code_url amerikan-gruzovik.ru,4590 tinatube.net,74861 sextelevizor.net,66791 ru.anysex.com,62743 www.asiamobil.ru,86865 www.chinamobil.ru,90045 ad-k.ru,2637 www.nik-store.ru,105112 video-seks.net,80108 russkoe-porno.info,63946 www.foxporns.com,94819 www.chrono24.com.ru,90117 www.wibes.ru,118283 german242.com,26297 santdom.ru,65100 treningchess.com,76231 razvedem.web-3.ru,60517 aktis-stroy.ru,3525 www.aktis-stroy.ru,85600 plot.name,56170 www.lichnycabinet.ru,100979 www.worldfishing.narod.ru,118532 sekretka.su,66123 www.a-centre.ru,85011 www.suzukirus.ru,113986 pornogl.com,57123 wmid234ru.ru,83678 hsi.ru,29794 infometer.ru,31244 www.git77.rostrud.ru,95784 www.packagetrackr.com,106632 www.tns-global.ru,115139 www.vipgroup.net,117281 www.toysrus.com,115433 moskva.wisell.ru,46046 www.shopjustice.com,111904 deti75.ru,16625 crimeacity.info,15195 baza.crimea.ua,8838 atelica-oazis.bron.me,6647 gokurort.ru,26990 mitula17.imhonet.ru,44811 foxbrest.imhonet.ru,24645 xavi.imhonet.ru,120090 ural.kp.ru,78539 spb.kp.ru,69996 pinkmarie.com,55650 geneva2015.cars.ru,26188 domodedovo.rujazi.com,18057 xn------5cdjccgu2avckptly3ad8p.xn--e1arcbfn.xn--p1ai,120241 baikalpress.ru,8328 klimovsk.mnogonado.net,35750 svet-modern.ru,72656 www.forex-kf.ru,94627 www.uniq-ip.com,116401 www.terrawoman.ua,114714 www.gorsovet.mk.ua,96192 vmr.gov.ua,81250 helpstu.su,28874 www.helpstu.su,96823 zab-nanny.ru,122892 kursak-diplom.com.ua,37838 kgu-journalist.ucoz.ru,34771 mospf.ru,46093 newdiplom.ucoz.ru,49231 www.autoezda.com,87258 referats.nashisrael.ru,60990 www.hotdiplom.ru,97129 fotorakom.com,24577 redirect.disqus.com,60900 www.sq.com.ua,113207 member.newsnet.in.ua,43580 bankomet.com.ua,8537 po4emu.ru,56252 www.po4emu.ru,107650 tric.info,76258 myotpusk.com,47714 yspehx.narod.ru,122777 vozhatiki.ru,81885 kirent.narod.ru,35483 www.festivalsearcher.com,94080 hotasianz.com.6716069.yupiromo.ru,29549 starblag.ucoz.ua,70955 www.medalbum.ru,102495 ab28ru.narod.ru,2336 diel.ks.ua,16931 aniplay.tv,5091 ugolzreniya.narod.ru,77854 vrn.vestipk.ru,81990 afg-hist.ucoz.ru,3023 www.shanson-plus.ru,111700 www.vsmolenske.ru,117854 vsetutonline.com,82254 stomatologmova.ucoz.ua,71506 xn----8sbgjprccxgonf4d1dya7b.xn--p1ai,120742 yarcube.ru,122335 www.pion.com.ru,107364 76yar.ru,1961 loveplanet-online.ru,40510 Нужно вернуть записи ‘code_url’, которые совпали с записями ‘cleanUrl’ в формате датафрейм. в полной версии файла 130 тыс. записей. Пробовал вложенным циклом, но процесс встал, очень долго. :
d=[] for a in range(len(df_label_url)): for b in range(len(df_label_url)): if df_label_url['code_url'][a]==df_label_url['cleanUrl'][b]: d.append(df_label_url['code_url'][a]) Предположительно так только в формате датафрейме:
[4590, 4590, 4590, 4590, 4590, 4590, 4590, 4590, 4590, 4590, 74861, 74861, 74861, 74861, 74861, 74861, 74861, 74861, 74861, 74861, 66791, 66791, 66791, 66791, 66791, 66791, 66791, 66791, 66791, 66791, 62743, 62743, 62743, 62743, 62743, 62743, 62743, 62743, 62743, 62743, 86865, 86865, 86865, 86865, 86865, 86865, 86865, 86865, 86865, 86865, 90045, 90045, 90045, 90045, 90045, 90045, 90045, 90045, 90045, 90045, 2637, 2637, 2637, 2637, 2637, 2637, 2637, 2637, 2637, 2637, 105112, 105112, 105112, 105112, 105112, 105112, 105112, 105112, 105112, 105112, 80108, 80108, 80108, 80108, 80108, 80108, 80108, 80108, 80108, 80108, 63946, 63946, 63946, 63946, 63946, 63946, 63946, 63946, 63946, 63946] Ошибки в данных
На прошлом занятии, посвященном практике EDA, мы работали с «чистыми данными», то есть такими данными, в которых нет ни ошибок, ни пропущенных значений. К сожалению, так бывает далеко не всегда.
Сегодня мы научимся очищать данные от дубликатов, неверных и плохо отформатированных значений, а также исправлять ошибки в дате и времени. На следующем занятии мы поговорим про работу с пропусками.
Содержание занятия
- Дубликаты
- Поиск дубликатов
- Удаление дубликатов
- Тип str вместо float
- Названия городов с заглавной буквы
Ошибки в данных могут встречаться по многим причинам. Они могут быть связаны с человеческим фактором, например, простой невнимательностью, или вызваны сбоями в работе записывающего какие-либо показатели оборудования.
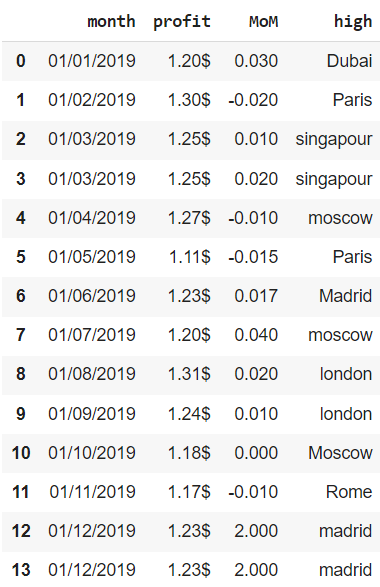
В качестве примера мы будем использовать несложный датасет, в котором содержатся данные за 2019 год об отдельных финансовых показателях сети магазинов одежды, представленной в нескольких городах мира. В частности, нам доступна следующая информация:
- month — за какой месяц сделана запись
- profit — прибыль (profit) по сети
- MoM — изменение выручки (revenue) сети по отношению к предыдущему месяцу
- high — магазин с наибольшей маржинальностью (margin) продаж
financials = pd . DataFrame ( < 'month' : [ '01/01/2019' , '01/02/2019' , '01/03/2019' , '01/03/2019' , '01/04/2019' , '01/05/2019' , '01/06/2019' , '01/07/2019' , '01/08/2019' , '01/09/2019' , '01/10/2019' , '01/11/2019' , '01/12/2019' , '01/12/2019' ] ,
‘profit’ : [ ‘1.20$’ , ‘1.30$’ , ‘1.25$’ , ‘1.25$’ , ‘1.27$’ , ‘1.11$’ , ‘1.23$’ , ‘1.20$’ , ‘1.31$’ , ‘1.24$’ , ‘1.18$’ , ‘1.17$’ , ‘1.23$’ , ‘1.23$’ ] ,
‘MoM’ : [ 0.03 , — 0.02 , 0.01 , 0.02 , — 0.01 , — 0.015 , 0.017 , 0.04 , 0.02 , 0.01 , 0.00 , — 0.01 , 2.00 , 2.00 ] ,
‘high’ : [ ‘Dubai’ , ‘Paris’ , ‘singapour’ , ‘singapour’ , ‘moscow’ , ‘Paris’ , ‘Madrid’ , ‘moscow’ , ‘london’ , ‘london’ , ‘Moscow’ , ‘Rome’ , ‘madrid’ , ‘madrid’ ]
financials
Воспользуемся методом .info() для получения общей информации о датасете.