sadedv / Encoding Java
Clone via HTTPS Clone with Git or checkout with SVN using the repository’s web address.
Learn more about clone URLs
Узнать текущую кодировку (charset), преобразовать в другую кодировку в Java
This file contains bidirectional Unicode text that may be interpreted or compiled differently than what appears below. To review, open the file in an editor that reveals hidden Unicode characters. Learn more about bidirectional Unicode characters
| public class Encodings |
| public static void main(String[] args) throws IOException |
| FileInputStream inputStream = new FileInputStream(«d:/data.txt»); |
| FileOutputStream outputStream = new FileOutputStream(«d:/data.txt»); |
| SortedMap charsets = Charset.availableCharsets();//список доступных кодировок |
| Charset currentCharset = Charset.defaultCharset();//узнать текущую кодировку |
| String s = «Good news everyone!»; |
| byte[] buffer = s.getBytes(«Windows-1251»);//создать массив байт в любой известной Java кодировке |
| byte[] fileBuffer = new byte[1000]; |
| inputStream.read(fileBuffer); |
| String s1 = new String(fileBuffer, «Windows-1251»);//преобразовать набор байт, прочитанных из файла в строку |
| //преобразовать набор байт из одной кодировки в другую |
| Charset koi8 = Charset.forName(«KOI8-R»); |
| Charset windows1251 = Charset.forName(«Windows-1251»); |
| byte[] buffer3 = new byte[1000]; |
| inputStream.read(buffer3); |
| String s3 = new String(buffer3, koi8); |
| buffer3 = s3.getBytes(windows1251); |
| outputStream.write(buffer3); |
| > |
| > |
Sign up for free to join this conversation on GitHub. Already have an account? Sign in to comment
Как узнать кодировку текстового файла
Есть программа которая обрабатывает текстовый файл. Нужно перед открытием и работой с файлом чтобы программа проверила кодировку текста. Подскажите как это реализовать, я только начинаю осваивать Java, буду признателен за пример кода.
Отслеживать
81.2k 7 7 золотых знаков 72 72 серебряных знака 153 153 бронзовых знака
задан 15 окт 2015 в 4:04
85 1 1 золотой знак 2 2 серебряных знака 3 3 бронзовых знака
Берем ваш вопрос, переводим на английский, вбиваем в гугл, открываем первую ссылку, копируем код, вставляем в свой проект.
15 окт 2015 в 5:07
@metalurgus ну если бы я мог так сделать разве я бы спрашивал? есть конкретные примеры? за ссылку буду признателен.
15 окт 2015 в 5:22
Что из вышеизложенного алгоритма вызывает у вас проблемы?
15 окт 2015 в 5:47
@metalurgus уровень английского не позволит правильно поставить вопрос а тем более разобраться в найденном материале
15 окт 2015 в 5:53
3 ответа 3
Сортировка: Сброс на вариант по умолчанию
Вообще это непростая задача и я думаю не всегда возможно это сделать. Обычно кодировку определяют заранее. Но действительно (как и сказал @metalurgus) довольно много информации в сети. Хотя, нужно понимать, что для решения такой задачи понадобится использовать какую-нибудь стороннюю библиотеку думаю вот это рассуждение подходит: определение кодировки
Отслеживать
ответ дан 15 окт 2015 в 6:14
Vladislav Pyatkov Vladislav Pyatkov
1,975 12 12 серебряных знаков 12 12 бронзовых знаков
это все очень геморно выглядит, может я не стой стороны зашол. ситуация такая, программа открывает и обрабатывает текстовый файл, но файл может попасть в любой кодировку, нужно или проверять кодировку чтобы не было крякозябр или как то запретить обработку если файл не подходит под конкретную кодировку.
15 окт 2015 в 13:55
@TСPakko и это просто так не запретишь (на файле не написано в какой кодировке там символы), только если читать и выкидывать ошибку разбора фала, если у него есть какой-то определённый формат (xml, css и т.д.).
15 окт 2015 в 14:48
Коллеги уже писали, что единого рецепта как бы нет, но я таки попытаюсь описать примерный паттерн решения этой задачи:
1) Получаем список поддерживаемых данной платформой кодировок Charset.availableCharset()
2) Берем первую по списку charset и читаем строчку из файла:
BufferedReader br = new BufferedReader( new InputStreamReader(new FileInputStream(filePath), charset)); String line=br.readLine(); 3) Берем Yandex Словарь и оформляем JSon запрос lookup, запоминаем статистику переводов
4) После прогона всех доступных кодировок выбираем ту, которая получила наилучшую статистику — это и будет наша искомая кодировка.
Java как определить кодировку файла
Здравствуйте, frёёm, Вы писали:
ёё>Оч. хочу класс который тупо читает любой поданный на вход xml файл в java.lang.String.
ёё>Проблема в том что хотелось бы определять кодировку файла на лету, если она задана.
не писал (ибо для этого парсеры всё-таки используются, а стринг он не нужен, к тому же всега сеть опасность, что он может оказаться неожиданно большим)
однако, пару подсказок могу дать:
см. здесь, каковы умолчания для xml-кодировки, если не задан пролог или в нём не указана кодировка
а если пролог задан, и в нём кодировка присутствует, то надо её извлечь и применить
т.е. всё укладывается в анализ первых байтов последовательности, ничего особо интеллектуального
Узнать кодировку xml файла
| От: | frёёm |
| Дата: | 03.03.08 10:49 |
| Оценка: |
Оч. хочу класс который тупо читает любой поданный на вход xml файл в java.lang.String.
Проблема в том что хотелось бы определять кодировку файла на лету, если она задана.
Наверняка кто-то, где-то уже что-то для этого написал ?
Ни что в жизни ни даёться так просто как. хотелось бы.
Re: Узнать кодировку xml файла
| От: | . |
| Дата: | 03.03.08 14:58 |
| Оценка: |
frёёm wrote:
> Оч. хочу класс который тупо читает любой поданный на вход xml файл в
> *java.lang.String*.
> Проблема в том что хотелось бы определять кодировку файла на лету, если
> она задана.
Файл содержит байты,а java.lang.String — символы. Путать нельзя.
> Наверняка кто-то, где-то уже что-то для этого написал ?
Даже если кто-то и писал, надеюсь уже переписал.
Posted via RSDN NNTP Server 2.1 beta
но это не зря, хотя, может быть, невзначай
гÅрмония мира не знает границ — сейчас мы будем пить чай
Re: Узнать кодировку xml файла
| От: | sss1024 | http://microforms.mobile-mir.com/ |
| Дата: | 03.03.08 17:21 | |
| Оценка: |
Здравствуйте, frёёm, Вы писали:
ёё>Добрый день.
ёё>Оч. хочу класс который тупо читает любой поданный на вход xml файл в java.lang.String.
ёё>Проблема в том что хотелось бы определять кодировку файла на лету, если она задана.
ёё>Наверняка кто-то, где-то уже что-то для этого написал ?
тоже сталкивался с вопросом чтения пролога
Это вобщем-то обычная задача но стандартных средств нет.
для чего может понадобится:
например хмл прочитать, поменять и потом сохранить в той же кодировке. Узнать кодировку можно только самому распарсив пролог. Неудобно.
Re[2]: Узнать кодировку xml файла
| От: | frёёm |
| Дата: | 03.03.08 19:46 |
| Оценка: |
Вообщем в итоге да.
Думал ограничиться utf’ами и прочесть первые несколько симоволов до указания encoding.
А потом плюнул, отдал файл парсеру.
Вообще идея была, прочесть xml в память и по нему делать xslt преобразования.
Посмотрев стандартный трансформер увидал что он строит по xml’лю DOM.
Так что вопрос отпал сам собой, сейчас парсером получаю w3c DOM и по нему работаю трансформером.
Автоопределение кодировки текста

Я очень люблю программировать, я любитель и первый и последний раз заработал на программировании в далёком 1996 году. Но для автоматизации повседневных задач иногда что-то пишу. Примерно год назад открыл для себя golang. В качестве инструмента создания утилит golang оказался очень удобным. Итак.
Возникла потребность обработать большое количество (больше тысячи, так и вижу улыбки профи) архивных файлов со специальной геофизической информацией. Формат файлов текстовый, простой. Если вдруг интересно то это LAS формат.
LAS файл содержит заголовок и данные.
Данные практически CSV, только разделитель табуляция или пробелы.
А заголовок содержит описание данных и вот в нём обычно содержится русский текст. Это может быть название месторождения, название исследований, записанных в файл и пр.
Файлы эти созданы в разное время и в разных программах, доходит до того, что в одном файле часть в кодировке CP1251, а часть в CP866. Файлы эти мне нужно обработать, а значит понять. Вот и потребовалось определять автоматически кодировку файла.
В итоге изобрёл велосипед на golang и соответственно родилась маленькая библиотечка с возможностью детектировать кодовую страницу.
Про кодировки. Не так давно на хабре была хорошая статья про кодировки Как работают кодировки текста. Откуда появляются «кракозябры». Принципы кодирования. Обобщение и детальный разбор Если хочется понять, что такое “кракозябры” или “кости”, то стоит прочитать.
В начале я накидал своё решение. Потом пытался найти готовое работающее решение на golang, но не вышло. Нашлось два решения, но оба не работают.
- Первое “из коробки”— golang.org/x/net/html/charset функция DetermineEncoding()
- Второе библиотека — saintfish/chardet на github
Обе уверенно ошибаются на некоторых кодировках. Стандартная та вообще почти ничего определить не может по текстовым файлам, оно и понятно, её для html страниц делали.
При поиске часто натыкался на готовые утилиты из мира linux — enca. Нашёл её версию скомпилированную для WIN32, версия 1.12. Её я тоже рассмотрю, там есть забавности. Я прошу сразу прощения за своё полное незнание linux, а значит возможно есть ещё решения которые тоже можно попытаться прикрутить к golang коду, я больше искать не стал.
Сравнение найденных решений на автоопределение кодировки
Подготовил каталог softlandia\cpd тестовые данные с файлами в разных кодировках. Содержимое файлов очень короткое и одинаковое. Одна строка “Русский в кодировке CodePageName”. Дополнил файлами со смешением кодировок и некоторыми сложными случаями и попробовал определить.
Мне кажется, получилось забавно.
| # | Кодировка | html/charset | saintfish/chardet | softlandia/cpd | enca |
|---|---|---|---|---|---|
| 1 | CP1251 | windows-1252 | CP1251 | CP1251 | CP1251 |
| 2 | CP866 | windows-1252 | windows-1252 | CP866 | CP866 |
| 3 | KOI8-R | windows-1252 | KOI8-R | KOI8-R | KOI8-R |
| 4 | ISO-8859-5 | windows-1252 | ISO-8859-5 | ISO-8859-5 | ISO-8859-5 |
| 5 | UTF-8 with BOM | utf-8 | utf-8 | utf-8 | utf-8 |
| 6 | UTF-8 without BOM | utf-8 | utf-8 | utf-8 | utf-8 |
| 7 | UTF-16LE with BOM | utf-16le | utf-16le | utf-16le | ISO-10646-UCS-2 |
| 8 | UTF-16LE without BOM | windows-1252 | ISO-8859-1 | utf-16le | unknown |
| 9 | UTF-16BE with BOM | utf-16le | utf-16be | utf-16be | ISO-10646-UCS-2 |
| 10 | UTF-16BE without BOM | windows-1252 | ISO-8859-1 | utf-16be | ISO-10646-UCS-2 |
| 11 | UTF-32LE with BOM | utf-16le | utf-32le | utf-32le | ISO-10646-UCS-4 |
| 12 | UTF-32LE without BOM | windows-1252 | utf-32le | utf-32le | ISO-10646-UCS-4 |
| 13 | UTF-32BE with BOM | windows-1252 | utf-32be | utf-32be | ISO-10646-UCS-4 |
| 14 | UTF-32BE without BOM | windows-1252 | utf-32be | utf-32be | ISO-10646-UCS-4 |
| 15 | KOI8-R (UPPER) | windows-1252 | KOI8-R | KOI8-R | CP1251 |
| 16 | CP1251 (UPPER) | windows-1252 | CP1251 | CP1251 | KOI8-R |
| 17 | CP866 & CP1251 | windows-1252 | CP1251 | CP1251 | unknown |
Наблюдение 1
enca не определила кодировку у файла UTF-16LE без BOM — это странно, ну ладно. Я попробовал добавить больше текста, но результата не получил.
Наблюдение 2. Проблемы с кодировками CP1251 и KOI8-R
Строка 15 и 16. У команды enca есть проблемы.
Здесь сделаю объяснение, дело в том, что кодировки CP1251 (она же Windows 1251) и KOI8-R очень близки если рассматривать только алфавитные символы.
Таблица CP 1251
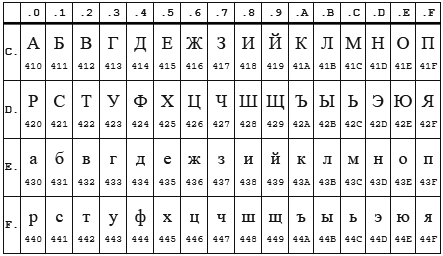
Таблица KOI8-r

В обеих кодировках алфавит расположен от 0xC0 до 0xFF, но там, где у одной кодировки заглавные буквы, у другой строчные. Судя по всему enca, работает по строчным буквам. Вот и получается, если подать на вход программе enca строку “СТП” в кодировке CP1251, то она решит, что это строка “яро” в кодировке KOI8-r, о чём и сообщит. В обратную сторону также работает.
Наблюдение 3
Стандартной библиотеке html/charset можно доверить только определение UTF-8, но осторожно! Пользоваться следует именно charset.DetermineEncoding(), поскольку метод utf8.Valid(b []byte) на файлах в кодировке utf-16be возвращает true.
Собственный велосипед
Автоопределение кодировки возможно только эвристическими методами, неточно. Если мы не знаем, на каком языке и в какой кодировке записан текстовый файл, то определить кодировку с высокой точночностью наверняка можно, но будет сложновато… и нужно будет достаточно много текста.
Для меня такая цель не стояла. Мне достаточно определять кодировки в предположении, что там есть русский язык. И второе, определять нужно по небольшому количеству символов – на 10 символах должно быть достаточно уверенное определение, а желательно вообще на 5–6 символах.
Алгоритм
Когда я обнаружил совпадение кодировок KOI8-r и CP1251 по местоположению алфавита, то на пару дней загрустил… стало понятно, что чуть-чуть придётся подумать. Получилось так.
- Работу будем вести со слайсом байтов, для совместимости с charset.DetermineEncoding()
- Кодировку UTF-8 и случаи с BOM проверяем отдельно
- Входные данные передаём по очереди каждой кодировке. Каждая сама вычисляет два целочисленных критерия. У кого сумма двух критериев больше, тот и выиграл.
Критерии соответствия
Первый критерий
Первым критерием является количество самых популярных букв русского алфавита.
Наиболее часто встречаются буквы: о, е, а, и, н, т, с, р, в, л, к, м, д, п, у. Данные буквы дают 82% покрытия. Для всех кодировок кроме KOI8-r и CP1251 я использовал только первые 9 букв: о, е, а, и, н, т, с, р, в. Этого вполне хватает для уверенного определения.
А вот для KOI8-r и CP1251 пришлось доработать напильником. Коды некоторых из этих букв совпадают, например буква о имеет в CP1251 код 0xEE при этом в KOI8-r этот код у буквы н. Для этих кодировок были взяты следующие популярные буквы. Для CP1251 использовал а, и, н, с, р, в, л, к, я. Для KOI8-r — о, а, и, т, с, в, л, к, м.
Второй критерий
К сожалению, для очень коротких случаев (общая длина русского текста 5-6 символов) встречаемость популярных букв на уровне 1-3 шт и происходит нахлёст кодировок KOI8-r и CP1251. Пришлось вводить второй критерий. Подсчёт количества пар согласная+гласная.
Такие комбинации ожидаемо наиболее часто встречаются в русском языке и соответственно в той кодировке в которой число таких пар больше, та кодировка имеет больший критерий.
Вычисляются оба критерия, складываются и полученная сумма является итоговым критерием.
Результат отражен в таблице выше.
Особенности, с которыми я столкнулся
Чуть коснусь прелестей и проблем, связанных с golang. Раздел может быть интересен только начинающим писать на golang.
Проблемы
Лично походил по некоторым подводным камушкам из 50 оттенков Go: ловушки, подводные камни и распространённые ошибки новичков.
Излишне переживая и пытаясь дуть на воду, прослышав от других о страшных ожогах от молока, переборщил с проверкой входного параметра типа io.Reader. Я проверял переменную типа io.Reader с помощью рефлексии.
//CodePageDetect - detect code page of ascii data from reader 'r' func CodePageDetect(r io.Reader, stopStr . string) (IDCodePage, error) < if !reflect.ValueOf(r).IsValid() < return ASCII, fmt.Errorf("input reader is nil") >. Но как оказалось в моём случае достаточно проверить на nil. Теперь всё стало проще
func CodePageDetect(r io.Reader, stopStr . string) (IDCodePage, error) < //test input interfase if r == nil < return ASCII, nil >//make slice of byte from input reader buf, err := bufio.NewReader(r).Peek(ReadBufSize) if (err != nil) && (err != io.EOF) < return ASCII, err >. вызов bufio.NewReader( r ).Peek(ReadBufSize) спокойно проходит следующий тест:
var data *os.File res, err := CodePageDetect(data)
В этом случае Peek() возвращает ошибку.
Разок наступил на грабли с передачей массивов по значению. Немного тупанул на попытке изменять элементы, хранящиеся в map, пробегая по ним в range…
Прелести
Сложно сказать что конкретно, постоянное ли битьё по рукам от линтера и компилятора или активное использование range, или всё вместе, но практически отсутствуют залёты по выходу индекса за пределы.
Конечно, очень приятно жить со сборщиком мусора. Полагаю мне ещё предстоит освоить грабли автоматизации выделения/освобождения памяти, но пока дебильная улыбка не покидает лица.
Строгая типизация — тоже кусочек счастья.
Переменные, имеющие тип функции — соответственно лёгкая реализация различного поведения у однотипных объектов.
Странно мало пришлось сидеть в отладчике, перечитывание кода обычно даёт результат.
Щенячий восторг от наличия массы инструментов из коробки, это чудное ощущение, когда компилятор, язык, библиотека и IDE Visual Studio Code работают на тебя вместе, слаженно.
Спасибо falconandy за конструктивные и полезные советы
Благодаря ему
- перевёл тесты на testify и они действительно стали более читабельны
- исправил в тестах пути к файлам данных для совместимости с Linux
- прошёлся линтером — таки он нашёл одну реальную ошибку (проклятущий copy/past)
Продолжаю добавлять тесты, выявился случай не определения UTF16. Обновил. Теперь UTF16 и LE и BE определяются даже в случае отсутствия русских букв