Ускорение конкатенации строк в Go своими руками
Сегодня мы будем разгонять склеивание коротких строк в Go на 30%. Причём для этого нам не нужно будет модифицировать сам Go, всё это будет реализованно в виде сторонней библиотеки.
Под катом вас ждут:
- Сравнение + , strings.Builder и собственной функции конкатенации
- Детали внутреннего устройства строк в Go
- Совсем немного ассемблера
Данную статью можно также считать предлогом обсудить CL123256: runtime,cmd/compile: specialize concatstring2. Идеи по улучшению этого change list’а приветствуются.
Сразу результаты
Сравнение производилось с go tip (master) версией компилятора. Аналогичные результаты вы можете получить на версиях примерно с Go 1.5. Последним значительным изменением функции concatstrings был CL3120: cmd/gc: allocate buffers for non-escaped strings on stack.
BenchmarkConcat2Operator-8 20000000 83.8 ns/op BenchmarkConcat2Builder-8 20000000 70.9 ns/op BenchmarkConcat2-8 20000000 62.1 ns/op BenchmarkConcat3Operator-8 20000000 104 ns/op BenchmarkConcat3Builder-8 20000000 89.9 ns/op BenchmarkConcat3-8 20000000 82.1 ns/opConcatOperator использует + .
ConcatBuilder использует strings.Builder с правильной пред-аллокацией.
Concat использует функцию, которую мы реализуем в рамках этой истории.
name old time/op new time/op delta Concat2-8 84.2ns ± 1% 62.7ns ± 2% -25.49% (p=0.000 n=9+10) Concat3-8 103ns ± 3% 83ns ± 4% -19.83% (p=0.000 n=10+9)Ассемблерная реализация под GOARCH=AMD64 немного быстрее и обладает дополнительной оптимизацией, которая присутствует у встроенного оператора + , но об этом ниже:
name old time/op new time/op delta Concat2-8 84.2ns ± 1% 57.1ns ± 3% -32.20% (p=0.000 n=9+9)Ассемблерную функцию будем брать как 100% производительности (относительно остальных рассматриваемых реализаций).
Результаты для более длинных строк можно увидеть в README.md. Чем длиннее строка, тем менее выражена разница между реализациями.
Наивная конкатенация
Самым простым решением является использование оператора + .
Семантика этого оператора такая: взять две строки и вернуть строку-результат, которая содержит сцепление обеих строк. При этом нет гарантии, что будет возвращена новая строка. Например, если происходит сцепление пустой строки и любой другой, runtime может вернуть непустой аргумент, избегая необходимости выделять новую память и копировать туда данные.
Но, как видно из результатов в начале статьи, это самый медленный способ.
func concat2operator(x, y string) string
Оценка производительности: 67.8%.
strings.Builder
Не так давно в Go добавили новый тип — strings.Builder. Это аналог bytes.Buffer , но при вызове метода String() не происходит повторного выделения памяти и копирования данных.
В отличие от bytes.Buffer , builder не имеет оптимизации малого буфера и, следовательно, предварительно аллоцированной памяти под строку. Если не использовать метод Grow , производительность будет хуже, чем в случае с bytes.Buffer . Несколько регрессий в Go 1.11 вызваны именно этой особенностью (см. CL113235).
В нашем коде, для чистоты эксперимента, мы будем избегать этой ошибки.
func concat2builder(x, y string) string < var builder strings.Builder builder.Grow(len(x) + len(y)) // Только эта строка выделяет память builder.WriteString(x) builder.WriteString(y) return builder.String() >Оценка производительности: 80.5% (+12.7).
Кодогенерация для конкатенации
Если посмотреть, какой код генерирует компилятор для оператора + , мы увидим вызовы функций concatstring2 , concatstring3 и так далее (до concatstring5 включительно).
func concat2codegen(x, y) string < return x + y >// => CALL runtime.concatstring2(SB) func concat3codegen(x, y, z) string < return x + y + z >// => CALL runtime.concatstring3(SB)func concatstring2(buf *tmpBuf, a [2]string) string < return concatstrings(buf, a[:]) >func concatstring3(buf *tmpBuf, a [3]string) string
Значит, осталось изучить функцию concatstrings .
Полный листинг доступен ниже под спойлером, а вот высокоуровневое описание:
- Параметр buf может быть nil . Этот буфер выделяется компилятором, если строка не «убегает» из области своего определения. Если же строка живёт дольше, чем фрейм, то этот буфер всегда будет nil (как чаще всего и происходит). Однако если этот буфер доступен, получится избежать аллокации в случае, если результат в него влезает (его размер — 32 байта).
- Если все строки, кроме одной, пустые, функция вернёт эту строку. Но при этом выделенные на стеке и покидающие свой фрейм строки минуют этой оптимизации, чтобы вызывающая сторона не получила уже освобождённую память.
- Далее все строки копируются в новую память.
Полный листинг функции concatstrings
// concatstrings implements a Go string concatenation x+y+z+. // The operands are passed in the slice a. // If buf != nil, the compiler has determined that the result does not // escape the calling function, so the string data can be stored in buf // if small enough. func concatstrings(buf *tmpBuf, a []string) string < idx := 0 l := 0 count := 0 for i, x := range a < n := len(x) if n == 0 < continue >if l+n < l < throw("string concatenation too long") >l += n count++ idx = i > if count == 0 < return "" >// If there is just one string and either it is not on the stack // or our result does not escape the calling frame (buf != nil), // then we can return that string directly. if count == 1 && (buf != nil || !stringDataOnStack(a[idx])) < return a[idx] >s, b := rawstringtmp(buf, l) for _, x := range a < copy(b, x) b = b[len(x):] >return s >Здесь мы видим сразу несколько мест, которые могут быть оптимизированы для частного случая:
- buf чаще всего пустой. Когда компилятор не смог доказать, что строку безопасно размещать на стеке, передача лишнего параметра и проверка его на nil внутри функции дают лишь накладные расходы.
- Для частного случая при len(a) == 2 нам не нужен цикл и вычисления можно упростить. А это самый распространённый вид конкатенации.
Статистика по использованию конкатенации
При выполнении ./make.bash (сборка Go компилятора и stdlib) видим 445 конкатенаций с двумя операндами:
- 398 результатов «убегают». В этом случае наша специализация имеет смысл.
- 47 результатов не покидают своего фрейма.
Итого 89% конкатенаций от двух аргументов попадают пот оптимизацию.
Для утилиты go имеем:
- 501 вызовов concatstring2
- 194 вызовов concatstring3
- 55 вызовов concatstring4
Версия для всех архитектур
Для реализации специализации нам потребуется знать, как в Go представлены строки. Нам важна бинарная совместимость, при этом unsafe.Pointer можно заменить на *byte без каких-либо жертв.
type stringStruct struct
Второй важный вывод, который мы можем сделать из рантайма: строки начинают свою жизнь мутабельными. Выделяется участок памяти, на который ссылается []byte , в который записывается содержимое новой строки, и только после этого []byte выбрасывается, а память, на которую он ссылался, сохраняется в stringStruct .
Для тех, кому хочется больше деталей, предлагается изучить функции rawstringtmp и rawstring .
runtime.rawstring
// rawstring allocates storage for a new string. The returned // string and byte slice both refer to the same storage. // The storage is not zeroed. Callers should use // b to set the string contents and then drop b. func rawstring(size int) (s string, b []byte) < p := mallocgc(uintptr(size), nil, false) stringStructOf(&s).str = p stringStructOf(&s).len = size *(*slice)(unsafe.Pointer(&b)) = slicereturn >Мы можем провернуть примерно то же самое, воспользовавшись тёмной стороной пакета unsafe :
func concat2(x, y string) string < length := len(x) + len(y) if length == 0 < return "" >b := make([]byte, length) copy(b, x) copy(b[len(x):], y) return goString(&b[0], length) >Мы выделяем []byte , который используем для формирования содержимого новой строки. Затем нам остаётся лишь финализировать строку приведением её к ожидаемому рантаймом представлению. За это отвечает функция goString :
func goString(ptr *byte, length int) string < s := stringStructreturn *(*string)(unsafe.Pointer(&s)) >Оценка производительности: 91.9% (+10.9).
Версия для AMD64
К сожалению, предыдущая версия функции не имеет оптимизации для конкатенации с пустой строкой, а ещё мы выполняем некоторое количество лишних вычислений из-за невозможности выделить память напрямую, приходится работать со слайсом байт.
Одной из интересных особенностей Go ассемблера является то, что он позволяет вызывать, например, неэкспортируемые функции рантайма. Мы можем вызвать runtime·mallocgc из ассемблерного кода даже если он не является частью пакета runtime . Этим свойством мы и воспользуемся.
Также мы можем проверять принадлежность строк стековой памяти, что делает безопасной оптимизацию возврата одного из аргументов в качестве результата.
Допустим, функция вызвана с аргументами concat2(«», «123») . x — пустая строка, и если y не выделен на стеке, мы можем вернуть его в качестве результата конкатенации.
//; Считаем, что x и y имеют тип stringStruct. //; CX - y.str. //; SI - y.len. maybe_return_y: //; Проверка на вхождения указателя в стек. MOVQ (TLS), AX //; *g CMPQ CX, (AX) JL return_y //; если y_str < g.stack.lo CMPQ CX, 8(AX) JGE return_y //; если y_str >= g.stack.hi JMP concatenate //; y на стеке, нужна новая аллокация return_y: MOVQ CX, ret+32(FP) //; stringStruct.len MOVQ SI, ret+40(FP) //; stringStruct.str RETMOVQ (TLS), AX переместит *g в регистр AX . Чтение по нулевому смещению даст поле g.stack.lo , а с 8-го байта начинается g.stack.hi (для 64-битной платформы).
type g struct < stack struct < lo uintptr // 0(AX) hi uintptr // 8(AX) >stackguard0 uintptr // 16(AX) stackguard1 uintptr // 24(AX) // . другие поля >Тело concatenate выделяет память, заполняет его обеими строками, и возвращает новую строку.
Полный листинг с комментариями
#include "textflag.h" #include "funcdata.h" TEXT ·Strings(SB), 0, $48-48 NO_LOCAL_POINTERS // Костыль для избежания ошибки. MOVQ x+0(FP), DX MOVQ x+8(FP), DI MOVQ y+16(FP), CX MOVQ y+24(FP), SI TESTQ DI, DI JZ maybe_return_y // x - пустая строка, попробуем вернуть y TESTQ SI, SI JZ maybe_return_x // y - пустая строка, попробуем вернуть x concatenate: LEAQ (DI)(SI*1), R8 // len(x) + len(y) // Выделяем память для новой строки. MOVQ R8, 0(SP) MOVQ $0, 8(SP) MOVB $0, 16(SP) CALL runtime·mallocgc(SB) MOVQ 24(SP), AX // Указатель на выделенную память MOVQ AX, newstr-8(SP) // Копируем x. MOVQ x+0(FP), DX MOVQ x+8(FP), DI MOVQ AX, 0(SP) MOVQ DX, 8(SP) MOVQ DI, 16(SP) CALL runtime·memmove(SB) // Копируем y со смещения len(x). MOVQ x+8(FP), DI MOVQ y+16(FP), CX MOVQ y+24(FP), SI MOVQ newstr-8(SP), AX LEAQ (AX)(DI*1), BX MOVQ BX, 0(SP) MOVQ CX, 8(SP) MOVQ SI, 16(SP) CALL runtime·memmove(SB) // Возврат новой строки. MOVQ newstr-8(SP), AX MOVQ x+8(FP), R8 ADDQ y+24(FP), R8 MOVQ AX, ret+32(FP) MOVQ R8, ret+40(FP) RET maybe_return_y: // Проверка на вхождения указателя в стек. MOVQ (TLS), AX // *g CMPQ CX, (AX) JL return_y // если y_ptr < stk.lo CMPQ CX, 8(AX) JGE return_y // если y_ptr >= stk.hi JMP concatenate // y на стеке, нужна новая аллокация return_y: MOVQ CX, ret+32(FP) MOVQ SI, ret+40(FP) RET maybe_return_x: // Проверка на вхождения указателя в стек. MOVQ (TLS), AX // *g CMPQ DX, (AX) JL return_x // если x_ptr < stk.lo CMPQ DX, 8(AX) JGE return_x // если x_ptr >= stk.hi JMP concatenate // x на стеке, нужна новая аллокация return_x: MOVQ DX, ret+32(FP) MOVQ DI, ret+40(FP) RETЕсли вам интересна природа NO_LOCAL_POINTERS в этом коде, можете почитать Calling a Go function from asm («fatal error: missing stackmap»).
Оценка производительности: 100% (+8.6).
В качестве заключения
Весь код предоставлен в качестве пакета concat.
Готов ли мир к такой быстрой конкатенации? Who knows.
В начале статьи был упомянут CL123256. У него есть несколько путей развития:
- Вариадичная специализация для случая, когда компилятором не выделен временный буфер. Меньше прирост на каждый случай, зато покрывает больше видов конкатенации и практически не увеличивает размер кода (как машинного, так и кода на Go).
- Больше специализаций для частных случаев. Выше прирост, но больше машинного кода, может навредить кешу инструкций.
- Тонны машинного кода, для каждого особого случая и специализированный memmove, на манер того как это сделано в glibc. Здесь в основном встают вопросы целесообразности.
Текущий предложенный вариант ускоряет только наиболее частый и простой случай конкатенации пары строк (арность=2).
Если в Go не примут это изменение, то сравнимого ускорения можно будет добиться с помощью реализации операций над строками в виде сторонней библиотеки. Менее удобно, красиво и элегантно, но зато работает.
- Программирование
- Assembler
- Системное программирование
- Компиляторы
- Go
Конкатенация строк и производительность
Советы от 5 февраля 2002 «Запись методов toString » (источник и перевод на JavaGu.ru) включали следующее предложение:
Обратите внимание, что использование «+» в toString для построения возвращаемого значения не всегда является самым эффективным подходом. Возможно, вы захотите использовать вместо этого StringBuffer .
Читатель технических советов отметил, что в документации по Java говорится о том, что для фактической реализации оператора + применяется StringBuffer . Поэтому возникает вопрос, какой выигрыш в производительности, если он существует, вы получите при явном использовании StringBuffer в ваших программах? В этой статье делается попытка ответить на этот вопрос.
Для начала рассмотрим пример, в котором строка формируется путем повторения одного и того же символа:
class MyTimer <
private final long start;
public MyTimer () start = System.currentTimeMillis () ;
>
public long getElapsed () return System.currentTimeMillis () — start;
>
>
public class AppDemo1 static final int N = 47500 ;
public static void main ( String args [])
// создать строку при помощи оператора +
MyTimer mt = new MyTimer () ;
String str1 = «» ;
for ( int i = 1 ; i str1 = str1 + «*» ;
>
System.out.println ( «elapsed time #1 = » + mt.getElapsed ()) ;
// создать строку при помощи StringBuffer
mt = new MyTimer () ;
StringBuffer sb = new StringBuffer () ;
for ( int i = 1 ; i sb.append ( «*» ) ;
>
String str2 = sb.toString () ;
System.out.println ( «elapsed time #2 = » + mt.getElapsed ()) ;
// проверка на равенство
if ( !str1.equals ( str2 )) System.out.println ( «str1/str2 mismatch» ) ;
>
>
>
После выполнения этой программы вы должны получить примерно следующий результат:
elapsed time # 1 = 61890
elapsed time # 2 = 16
Подход №2 явно использует StringBuffer , тогда как подход №1 использует его неявно, как часть реализации оператора + . Вы можете исследовать байт-коды, использующиеся для реализации первого подхода при помощи команды:
javap -c -classpath . AppDemo1
Разница в «+» и StringBuffer
Откуда такая огромная разница между этими двумя подходами? Во втором подходе символы добавляются в StringBuffer , что довольно эффективно. А в первом подходе не используется этот метод? На самом деле нет. Выражение:
str1 = str1 + «*» ;
не добавляет символы к строке str1 . Это происходит из-за того, что Java-строки постоянны, они не изменяются после создания. Вот что происходит в действительности:
- StringBuffer создается
- str1 копируется в него
- «*» добавляется в буфер
- Результат преобразуется в строку
- Ссылка str1 меняется для указания на эту строку
- Старая строка, на которую ранее ссылалась переменная str1 , делается доступной для сборщика мусора.
Цикл проходит через N итераций, и на каждой итерации содержимое str1 (содержащей N-1 символов) должно быть скопировано в буфер. Такое поведение подразумевает, что первый подход имеет квадратичную или худшую производительность. «Квадратичная» означает, что время выполнения пропорционально квадрату N. Есть вероятность эффективно заморозить приложение при применении такого типа цикла.
В примере AppDemo1 демонстрируется ситуация, когда периодически присоединяется одна строка к другой, так что обе строки должны быть скопированы во временную область ( StringBuffer ), создана новая строка и, затем, ссылка на оригинальную строку заменяется ссылкой на новую строку.
Но что если вы не выполняете этот тип операции, а вместо этого, просто имеете некоторый код, похожий на следующий:
public String toString () <
return «X=» + x + » Y=» + y;
>
Здесь нет цикла или повторений и нет строки, которая становится все длиннее и длиннее. Есть какой-либо вред от применения + вместо StringBuffer в этом примере?
Поясняющий пример
В примере AppDemo1 демонстрируется ситуация, когда периодически присоединяется одна строка к другой, так что обе строки должны быть скопированы во временную область ( StringBuffer ), создана новая строка и, затем, ссылка на оригинальную строку заменяется ссылкой на новую строку.
Но что если вы не выполняете этот тип операции, а вместо этого, просто имеете некоторый код, похожий на следующий:
public String toString () <
return «X=» + x + » Y=» + y;
>
Здесь нет цикла или повторений и нет строки, которая становится все длиннее и длиннее. Есть какой-либо вред от применения + вместо StringBuffer в этом примере?
Для ответа на этот вопрос рассмотрим дополнительный код:
class MyPoint <
private final int x, y;
private final String cache;
public MyPoint ( int x, int y ) this .x = x;
this .y = y;
cache = «X=» + x + » Y=» + y;
>
public String toString1 () return «X=» + x + » Y=» + y;
>
public String toString2 () StringBuffer sb = new StringBuffer () ;
sb.append ( «X=» ) ;
sb.append ( x ) ;
sb.append ( » Y=» ) ;
sb.append ( y ) ;
return sb.toString () ;
>
public String toString3 () String s = «» ;
s = s + «X=» ;
s = s + x;
s = s + » Y=» ;
s = s + y;
return s;
>
public String toString4 () return cache;
>
>
class MyTimer private final long start;
public MyTimer () start = System.currentTimeMillis () ;
>
public long getElapsed () return System.currentTimeMillis () — start;
>
>
public class AppDemo2 static final int N = 1000000 ;
public static void main ( String args []) MyPoint mp = new MyPoint ( 37 , 47 ) ;
String s1 = null ;
String s2 = null ;
String s3 = null ;
String s4 = null ;
MyTimer mt = new MyTimer () ;
for ( int i = 1 ; i s1 = mp.toString1 () ;
>
System.out.println ( «toString1 » + mt.getElapsed ()) ;
mt = new MyTimer () ;
for ( int i = 1 ; i s2 = mp.toString2 () ;
>
System.out.println ( «toString2 » + mt.getElapsed ()) ;
mt = new MyTimer () ;
for ( int i = 1 ; i s3 = mp.toString3 () ;
>
System.out.println ( «toString3 » + mt.getElapsed ()) ;
mt = new MyTimer () ;
for ( int i = 1 ; i s4 = mp.toString4 () ;
>
System.out.println ( «toString4 » + mt.getElapsed ()) ;
// проверка исправности для того, чтобы убедиться,
// что результаты, возвращенные из каждого метода toString идентичны
if ( !s1.equals ( s2 ) || !s2.equals ( s3 ) || !s3.equals ( s4 )) System.out.println ( «check error» ) ;
>
>
>
В этой программе создается класс MyPoint , который используется для представления точек X,Y . В ней реализуются различные методы toString для класса. Результат выполнения программы может выглядеть примерно так:
toString1 2797
toString2 2703
toString3 5656
toString4 32
Расшифровка результатов
Первые два способа, использующие + и StringBuffer , имеют примерно одинаковую производительность. Поэтому вы можете сделать вывод, что эти два способа фактически идентичны. Генерируемый для toString1 байт-код указывает, что создается StringBuffer , а затем различные строки просто добавляются к нему. Полученный код очень похож на toString2 .
Но не все так просто. Первая проблема в том, что вы не всегда сможете сформулировать возвращаемое из toString значение в виде отдельного выражения. toString3 и toString1 показывают идентичные результаты. Но время работы toString3 в два раза больше по причине, описанной в примере AppDemo1 . Пример AppDemo2 демонстрирует ситуацию, когда надо создать возвращаемое значение за один раз. В этом случае toString2 , использующий явно StringBuffer , является более хорошим выбором.
Другая проблема касается высказывания, найденного в «Спецификации по языку программирования Java» в разделе 15.18.1.2, в котором говорится:
Реализация может выполнить преобразование и конкатенацию за один шаг, чтобы избежать создания и удаления промежуточного объекта String . Для увеличения производительности повторных конкатенаций строки компилятор Java может использовать класс StringBuffer или аналогичную технику для уменьшения количества промежуточных объектов String , создающихся при вычислении выражения.
Это утверждение говорит о том, что компилятор Java не обязательно оптимизирует такое выражение как:
str1 + str2 + str3 + .
как это сделано для метода toString1 , а может вместо этого создать промежуточные строковые объекты.
Поэтому будьте осторожны при использовании оператора + , особенно для длинных строк или в циклах.
Отметим, что существует даже более быстрый способ реализации toString для этого примера. MyPoint является постоянным классом. Это означает, что его экземпляры не могут быть модифицированы после создания. Учитывая это, возвращаемое из toString значение всегда будет одним и тем же. Поскольку значения одинаковы, оно может быть вычислено один раз в конструкторе MyPoint и затем просто возвращено из toString4 .
Такой вид кэширования часто очень полезен, но есть и отрицательные стороны. Если класс является изменяемым, то кэширование может не иметь смысла. Тоже самое можно сказать и для ситуаций, когда вычисление значения кэша трудоемко, когда кэш занимает много памяти, или когда метод toString вызывается нечасто.
Ссылки
Дополнительная информация по этой теме находится в разделе 15.18.1 «Оператор конкатенации строк +» в «Спецификации по языку программирования Java, второе издание (http://java.sun.com/docs/books/jls/), и в разделе 5 «Строки» книги «Настройка производительности Java» Jack Shirazi.
A может Вас также заинтересует что-нибудь из этого:
- Разное → Теория и практика Java: Динамическая компиляция и измерение производительности
- Java сниппеты → Какой длины ваша строка?
- Java Standard Edition → Блокировки
- Java сниппеты → Блоки статической и объектной инициализации
- Java сниппеты → Методы для работы с переменным количеством аргументов
- Java Standard Edition → Производительность операций ввода/вывода в Java
Эффективность на максимум: Микрооптимизации в Golang
Каждая миллисекунда имеет значение, микрооптимизация это must have, особенно на языке Go.
Казалось бы, современные пекарни настолько мощные, что могут простить нам небольшую неэффективность. Однако, когда дело доходит до масштабируемых систем и высоконагруженных приложений, каждая лишняя аллокация памяти и каждый неоптимальный цикл могут привести к значительному снижению производительности. Микрооптимизации позволяют добиться максимальной эффективности и производительности.
Особенности Golang
Компилируемость позволяет Golang преобразовывать ваш код в нативный машинный код для целевой платформы. Такой подход обеспечивает высокую производительность и оптимизацию ресурсов. Это как раз то, что нужно для создания быстрых и эффективных приложений. Компиляция кода в нативный машинный код означает, что ваше приложение будет работать более эффективно, используя меньше ресурсов системы, и, что немаловажно, обеспечивая более высокую скорость выполнения по сравнению с интерпретируемыми языками.
Goroutines
Goroutines — это функции или методы, выполняемые параллельно с другими goroutines в том же адресном пространстве. Это легковесные потоки, которые управляются Go runtime. Они занимают значительно меньше памяти по сравнению с традиционными потоками и могут быть созданы в боьших количествах без значительных затрат ресурсов системы.
Преимущества Goroutines:
- Легковесность: Goroutines занимают намного меньше памяти, чем традиционные потоки. Они начинаются с маленького стека, который может динамически расширяться и сжиматься.
- Быстрое переключение контекста: Поскольку goroutines более легковесны, их контекст переключается гораздо быстрее, что повышает производительность приложения, особенно в многопоточных сценариях.
- Простота использования: Создание и управление goroutines в Go значительно проще, чем управление потоками в других языках программирования.
Простой пример:
package main import ( "fmt" "time" ) func say(s string) < for i := 0; i < 5; i++ < time.Sleep(100 * time.Millisecond) fmt.Println(s) >> func main()
Запускаем функцию say в goroutine с помощью ключевого слова go . Это позволяет функции say(«world») выполняться параллельно с say(«hello») . Вы увидите, что вывод между «hello» и «world» будет череоваться, что демонстрирует параллельное выполнение.
Синхронизация Goroutines
Часто возникает необходимость в синхронизации работы между разными goroutines. Для этого в Go есть механизмы, такие как каналы (channels) и WaitGroup.
package main import ( "fmt" "sync" "time" ) func worker(id int, wg *sync.WaitGroup) < defer wg.Done() fmt.Printf("Worker %d starting\n", id) time.Sleep(time.Second) fmt.Printf("Worker %d done\n", id) >func main() < var wg sync.WaitGroup for i := 1; i wg.Wait() >Используем sync.WaitGroup для ожидания завершения всех goroutines. Каждый вызов worker увеличивает счетчик WaitGroup, и wg.Wait() блокирует выполнение до тех пор, пока счетчик не опустится до нуля.
Более подробно с горутинами можете ознакомиться в нашей статье.
Указатели в Go
Указатель в Go — это переменная, значение которой является адресом другой переменной в памяти. Указатели играют ключевую роль в управлении памятью и обработке данных, позволяя работать непосредственно с памятью и избегать ненужного копирования данных.
Основы указателей:
- Создание указателя: Используется оператор & для получения адреса переменной.
- Разыменование указателя: Используется оператор * для доступа к значению по адресу, на который указывает указатель.
В Go можно передать объект функции либо по значению, либо по указателю. Передача по значению создает копиюобъекта, в то время как передача по указателю позволяет функции работать непосредственно с объектом, не создавая его копию.
Передача по значению:
- Каждый раз создается новая копия данных.
- Изменения, сделанные в функции, не отражаются на исходных данных.
- Более безопасно, но может быть менее эффективно для больших структур данных.
Передача по указателю:
- Работа идет непосредственно с данными, а не с их копией.
- Изменения в данных влияют на исходные данные.
- Эффективнее для больших структур данных, но требует более аккуратного управления.
Передача по значению
package main import "fmt" func updateValue(val int) < val += 10 >func main() < x := 20 updateValue(x) fmt.Println(x) // Выводит 20, так как x не изменяется >Изменения, внесенные в функции updateValue , не отражаются на переменной x , поскольку x передается по значению.
Передача по указателю
package main import "fmt" func updatePointer(val *int) < *val += 10 >func main() < x := 20 updatePointer(&x) fmt.Println(x) // Выводит 30, так как x изменяется через указатель >Функция updatePointer получает указатель на x и изменяет значение x , используя разыменование указателя.
Бенчмаркинг в Golang
Бенчмаркинг — это не просто дополнительная функция, а фундаментальная часть экосистемы Golang. Встроенный в язык пакет testing предоставляет мощные средства для написания бенчмарков. Это позволяет не только тестировать функциональность своего кода, но и оценивать его производительность в различных условиях. Бенчмарки в Golang — это не что иное, как функции, начинающиеся с Benchmark , которые выполняют определенный код определенное количество раз, позволяя замерять время выполнения и производительность.
Go также предлагает инструменты для статического анализа кода, такие как vet и lint , которые анализируют исходный код на предмет общих ошибок и практик, которые могут привести к багам или неэффективному коду.
Конкатенация строк в Go
Конкатенация строк — это процесс соединения двух или более строк в одну. В Golang существует несколько способов сделать это, включая использование оператора + , функции fmt.Sprintf , и метода strings.Builder . Каждый из этих методов имеет свои преимущества и недостатки с точки зрения производительности, которые могут быть выявлены с помощью бенчмарков.
Простая конкатенация с оператором +
package main import ( "testing" ) func BenchmarkConcatOperator(b *testing.B) < str1 := "Hello, " str2 := "World!" for i := 0; i < b.N; i++ < _ = str1 + str2 >>В этом примере мы измеряем производительность конкатенации двух строк с помощью оператора + . Это простой и часто используемый способ, но он может быть неэффективным при соединении большого количества строк из-за необходимости постоянного создания новых строк.
Использование fmt.Sprintf
package main import ( "fmt" "testing" ) func BenchmarkSprintf(b *testing.B) < str1 := "Hello, " str2 := "World!" for i := 0; i < b.N; i++ < _ = fmt.Sprintf("%s%s", str1, str2) >>fmt.Sprintf предоставляет более гибкий способ конкатенации, позволяя вставлять переменные в строку. Однако, этот метод может быть менее производительным из-за дополнительной обработки форматирования.
Использование strings.Builder
package main import ( "strings" "testing" ) func BenchmarkStringBuilder(b *testing.B) < str1 := "Hello, " str2 := "World!" for i := 0; i < b.N; i++ < var sb strings.Builder sb.WriteString(str1) sb.WriteString(str2) _ = sb.String() >>strings.Builder — это более эффективный способ для конкатенации строк, особенно при работе с большим количеством строк. Этот метод минимизирует количество аллокаций памяти, что делает его предпочтительным выбором для высокопроизводительных операций.
Для запуска этих бенчмарков, нужно использовать команду go test -bench=. . После запуска, Go выполнит каждый бенчмарк и предоставит информацию о времени выполнения и количестве операций в секунду. Анализируя эти результаты, можно определить, какой метод конкатенации строк является наиболее эффективным в различных сценариях.
pprof предоставляет детальное представление о том, как ваше приложение использует системные ресурсы, включая CPU и память, что позволяет выявить узкие места и потенциальные области для улучшения.
pprof — это инструмент для визуализации и анализа данных профилирования, встроенный в runtime Go. Он собирает данные о производительности вашего приложения, такие как время выполнения функций и использование памяти, и предоставляет их в виде легко читаемых отчетов.
Профайлинг с pprof включает в себя несколько этапов:
- Интеграция pprof в ваше приложение:
Чтобы использовать pprof , необходимо импортировать пакет net/http/pprof в ваше приложение. Это автоматически добавляет обработчики pprof к вашему HTTP-серверу - Сбор данных профилирования:
Данные профилирования могут быть собраны во время выполнения вашего приложения. Вы можете профилировать различные аспекты, такие как использование CPU или памяти. - Анализ результатов:
После сбора данных вы можете визуализировать их с помощью инструментов pprof для анализа и выявления узких мест.
Простой HTTP-сервер с pprof
package main import ( "log" "net/http" _ "net/http/pprof" ) func main() < http.HandleFunc("/", func(w http.ResponseWriter, r *http.Request) < w.Write([]byte("Привет от ОТУС!")) >) log.Println("Сервер запущен на :8080") log.Fatal(http.ListenAndServe(":8080", nil)) >В этом примере мы создаем простой HTTP-сервер и интегрируем pprof . Теперь вы можете посещать http://localhost:8080/debug/pprof/ для доступа к данным профилирования.
Сбор данных CPU профиля
Для сбора CPU профиля, можно использовать:
go tool pprof http://localhost:8080/debug/pprof/profileЭта команда запустит профилирование CPU на 30 секунд (по умолчанию) и сохранит профиль для дальнейшего анализа.
После сбора профиля вы можете анализировать его с помощью различных команд в pprof , таких как top , которая показывает функции, использующие наибольшее количество CPU, или web , которая визуализирует профиль в виде графа вызовов.
Использование ресурсов и аллокация памяти
Профилирование использования CPU и памяти помогает выявить функции и операции, которые наиболее требовательны к ресурсам. Для этого pprof предоставляет два основных типа профилей: CPU профиль и профиль памяти (heap profile).
CPU профилирование позволяет увидеть, какие функции потребляют больше всего процессорного времени. Это дает представление о том, какие части кода наиболее интенсивно используют CPU.
import ( "net/http" _ "net/http/pprof" ) func main() < go func() < http.ListenAndServe("localhost:6060", nil) >() >Затем вы можете собрать CPU профиль, используя следующую команду:
go tool pprof http://localhost:6060/debug/pprof/profileПрофилирование памяти (Heap Profiling)
Профилирование памяти помогает выявить места в коде, где происходит большая часть аллокаций. Это помогает понять, как управлять памятью более эффективно и выявить потенциальные утечки памяти.
go tool pprof http://localhost:6060/debug/pprof/heapБлокировки и потоки
pprof также предлагает профилирование блокировок и потоков, которые могут помочь выявить проблемы с конкурентностью и параллелизмом в приложении.
Профилирование блокировок позволяет увидеть, где происходят частые или продолжительные блокировки, что может указывать на проблемы с конкуренцией или неэффективное использование мьютексов.
import ( "runtime" "net/http" _ "net/http/pprof" ) func main() < runtime.SetMutexProfileFraction(1) go func() < http.ListenAndServe("localhost:6060", nil) >() // ваш код >Профиль блокировок собирается так:
go tool pprof http://localhost:6060/debug/pprof/mutexПотоки (Goroutine Profiling)
Профилирование потоков (goroutines) помогает понять, как распределяются и используются goroutines в вашем приложении. Это может выявить места, где goroutines накапливаются или блокируются.
go tool pprof http://localhost:6060/debug/pprof/goroutinesync.Pool
sync.Pool — это кэш объектов, который может быть использован для хранения и повторного использования объектов. Полезно в сценариях, где выделение памяти для объектов происходит часто, и эти объекты имеют схожий размер или структуру. Использование sync.Pool помогает снизить количество аллокаций памяти, что в свою очередь уменьшает нагрузку на сборщик мусора и повышает производительность приложения.
sync.Pool предоставляет два основных метода: Get и Put . Метод Get используется для получения объекта из пула. Если пул пуст, Get автоматически создает новый объект с помощью функции, предоставленной в New . Метод Put используется для возвращения объекта в пул для последующего повторного использования.
Пул буферов
Один из частых примеров использования sync.Pool — это пул буферов для временных данных, например, при формировании строк.
package main import ( "bytes" "fmt" "sync" ) var bufPool = sync.Pool < New: func() interface<>< return new(bytes.Buffer) >, > func getBuffer() *bytes.Buffer < return bufPool.Get().(*bytes.Buffer) >func putBuffer(buf *bytes.Buffer) < buf.Reset() bufPool.Put(buf) >func main()
В этом примере, мы создаем пул для объектов bytes.Buffer . Каждый раз, когда нам нужен буфер, мы берем его из пула, используем и возвращаем обратно, что позволяет избежать ненужных аллокаций.
Пул сложных объектов
sync.Pool также полезен для более сложных объектов, которые дорогостоящи в создании или инициализации.
package main import ( "fmt" "sync" ) type ComplexObject struct < // представим, что здесь много полей >var objectPool = sync.Pool < New: func() interface<> < // дорогостоящая операция инициализации return &ComplexObject<>>, > func getObject() *ComplexObject < return objectPool.Get().(*ComplexObject) >func putObject(obj *ComplexObject) < objectPool.Put(obj) >func main() < obj := getObject() // использование obj putObject(obj) // возврат в пул для повторного использования >В этом случае, sync.Pool используется для управления пулом сложных объектов, что помогает снизить нагрузку на сборщик мусора и улучшить производительность приложения.
Заключение
Микрооптимизации в Golang позволяет максимизировать эффективность и производительность приложений. Не забывайте помнить балансе между оптимизацией и читаемостью кода, а также о том, что оптимизации следует применять с умом, основываясь на реальных измерениях и анализе производительности.
Больше практических навыков и лайфхаков вы можете получить от практикующих экспертов отрасли в рамках онлайн-курса Golang Developer. Professional. А тех, кого интересуют другие языки программирования, приглашаю ознакомиться с каталогом курсов, в котором каждый найдет подходящее направление.
Конкатенация строк в Golang
Помимо встроенного оператора + , в Go есть много других способов для конкатенации строк. Далее будет дана простая инструкция для конкатенации, или слияния строк с помощью пакета bytes и встроенной функции copy .
Как конкатенировать строки в Golang?
1. Создайте файл concat_buffer.go со следующим содержимым:
Премиум �� канал по Golang
Рекомендуем вам супер TELEGRAM канал по Golang где собраны все материалы для качественного изучения языка. Удивите всех своими знаниями на собеседовании! ��
Уроки, статьи и Видео
Мы публикуем в паблике ВК и Telegram качественные обучающие материалы для быстрого изучения Go. Подпишитесь на нас в ВК и в Telegram. Поддержите сообщество Go программистов.
concat_buffer.go
package main
strings : = [ ] string < "This " , "is " , "even " , "more " , "performant " >
buffer : = bytes . Buffer < >
for _ , val : = range strings <
buffer . WriteString ( val )
fmt . Println ( buffer . String ( ) )
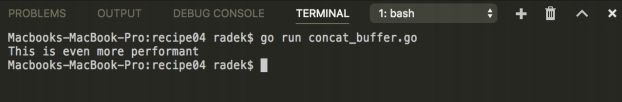
2. Запустите код через go run concat_buffer.go ;
3. Посмотрите на вывод в терминале:
4. Создайте файл concat_copy.go со следующим содержимым:
concat_copy.go
package main
strings : = [ ] string < "This " , "is " , "even " ,
"more " , "performant " >
bs : = make ( [ ] byte , 100 )
for _ , val : = range strings <
bl += copy ( bs [ bl : ] , [ ] byte ( val ) )
fmt . Println ( string ( bs [ : ] ) )
5. Запустите код через go run concat_copy.go ;
6. Посмотрите на результат в терминале:
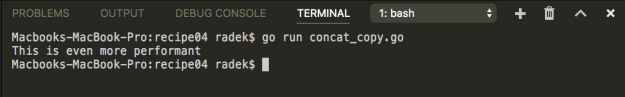
Код слияния строк в Golang
В шагах 1-3 описывается использование Buffer из пакета bytes в качестве отличного (в плане производительности) решения конкатенации строк. Структура Buffer имплементирует метод WriteString , что может использоваться для эффективной конкатенации строк в базовый байтовый срез.
Нет нужды использовать данное решение во всех случаях. Просто помните о нем, когда программа должна конкатенировать крупное число строк. К примеру, экспорт содержимого большого CSV-файла и прочих.
Встроенная функция copy из шагов 4-6 может использоваться для конкатенации string . Данный метод требует некоторых предположений касательно длины финальной строки, он также может использоваться на ходу. Однако, если вместимость буфера места написания результата меньше уже написанной части и добавленной строки, буфер требуется расширить. Это обычно делается через выделение нового среза с большей вместимостью.
Сравнение способов конкатенации в Golang
Сравним несколько способов конкатенации строк в Golang. Это использование оператора + , bytes.Buffer и встроенной функции copy .
1. Создайте папку bench и файл bench_test.go внутри со следующем содержимым: